Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Bioinformatik Virtuelle Knockout Molekulardynamik RNAseq DTA
Ich validiere Verbindungen-SMILES und Proteinsequenzen, führe ein vorhandenes Affinitätsmodell aus und liefere passende Vorhersagen, Status pro Zeile, eine Rangliste sowie Modell-/Versionshinweise. Grundlegend: bis zu 1.000 Paare und 20 Proteine.
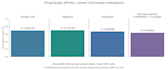
Verfügbare Routen: bilineare DTA, DeepDTA, GraphDTA und eine MolTrans-ausgewählte ChemBERTa Cross-Aufmerksamkeitsvariante mit Länge-Maske-Reparatur.
Unsere gespeicherten Aufzeichnungen verwenden BindingDB Ki/Kd-abgeleitete pKi/pKd-Bezeichnungen, eingefrorene NPZ-Splits und Cold-Target-Evaluation (Testproteine außerhalb des Trainings). Übereinstimmungsindizes: bilinear 0,695145; DeepDTA 0,702238; GraphDTA 0,668996; reparierte MolTrans-abgeleitete Variante 0,636565. Dies sind routenspezifische Checkpoint-Aufzeichnungen, kein gemeinsamer Testvergleich.
CSV-Spalten senden: sample_id, smiles und protein_sequence; füge compound_id/target_id hinzu, falls vorhanden. Bestimme Modell und Rangfolge pro Target. Vorhersagen unterstützen die Priorisierung von Kandidaten.
Gewichte und einsatzbereite Deployments-Pakete können nach separater Vereinbarung nach Prüfung von Assets und Distribution bereitgestellt werden. Mehrere Modelle, Retraining und neue Validierungssplits fallen unter gesonderte Leistungsbereiche. Kontaktiere mich vor der Bestellung.

Expertise:
Rangliste
•
Prädiktive Analyse
Programmiersprache:
Python
Frameworks:
PyTorch
