Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD



Automatische Übersetzung
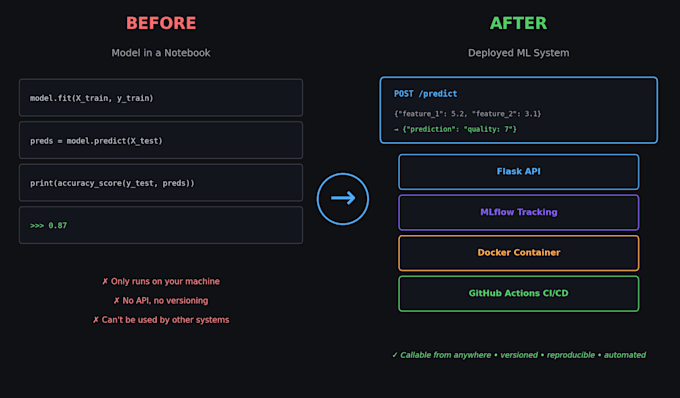
„Die meisten Freelancer liefern dir ein Jupyter-Notebook. Ich baue produktionsreife ML-Pipelines, die trainiert, verfolgt, containerisiert und als funktionierende API bereitgestellt werden, inklusive CI/CD, damit dein Modell wirklich ausgeliefert wird und nicht nur in einem Notebook sitzt.“
Was du bekommst:
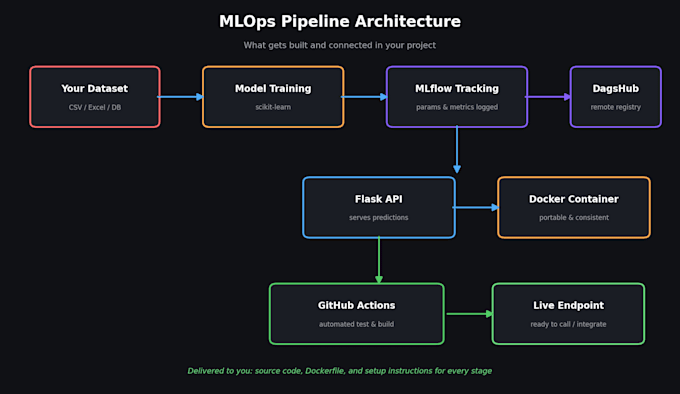
-Modelltraining & Bewertung (scikit-learn)
-Flask API für Echtzeitvorhersagen
-Experiment-Tracking mit MLflow
-Dockerisiert für konsistente Bereitstellung überall
-GitHub Actions CI/CD-Pipeline (Premium)
-Vollständige Dokumentation (Premium)
Ideal für:
Startups, die eine funktionierende ML-API brauchen, Forscher, die ihr Modell bereitstellen möchten, Unternehmen, die einen Proof-of-Concept wollen, der tatsächlich läuft, nicht nur ein Notebook.
Teile dein Dataset und Anwendungsfall, und ich bestätige das passende Paket, bevor du bestellst.“
AI Developer,, Data Scientist and Backend Developer
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Trainierst du das Modell oder muss ich schon ein trainiertes Modell bereitstellen?
Beides ist möglich — ich kann ein Modell von Grund auf mit deinem Dataset trainieren oder dein bestehendes trainiertes Modell nehmen und die Deployment-Pipeline darum herum aufbauen. Erwähne einfach, was zutrifft, in deiner Bestellung.
Wird die API im Internet live sein oder nur lokal laufen?
Du erhältst einen voll funktionsfähigen Docker-Container, den du (oder dein Team) überall deployen kannst. Live-Cloud-Hosting (AWS/GCP/Azure) ist standardmäßig nicht inklusive — schreib mir zuerst, wenn du das brauchst, damit ich es richtig einschätzen kann.
Was ist der Unterschied zwischen den Paketen?
Basic umfasst ein trainiertes Modell + Flask API. Standard fügt MLflow-Experiment-Tracking und Docker-Containerisierung hinzu. Premium beinhaltet eine vollständige GitHub Actions CI/CD-Pipeline, vollständige Dokumentation und zwei Überarbeitungsrunden.
Was, wenn mein Dataset vor dem Modellieren gereinigt werden muss?
Grundlegende Reinigung ist inklusive. Wenn dein Dataset umfangreiche Vorverarbeitung benötigt, werde ich das vor Beginn anmerken, damit wir Scope und Zeitplan abstimmen können.
Kannst du auch mit Deep-Learning-Modellen (TensorFlow/PyTorch) arbeiten, nicht nur mit scikit-learn?
scikit-learn ist mein Standard für tabellarische Daten, aber ich kann auch mit TensorFlow oder PyTorch Modellen arbeiten — nenne dein Framework bei der Bestellung.
Bekomme ich den Quellcode?
Ja — vollständiger Quellcode, Dockerfile und Setup-Anleitung sind in jedem Paket enthalten.
Ist Support nach der Lieferung inklusive?
Kleine Bugfixes sind während der Überarbeitungsphase abgedeckt. Laufende Wartung oder neue Features können als separate Bestellung arrangiert werden.