Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Full Stack Entwickler React, Angular, WP, Computer Vision Engineer
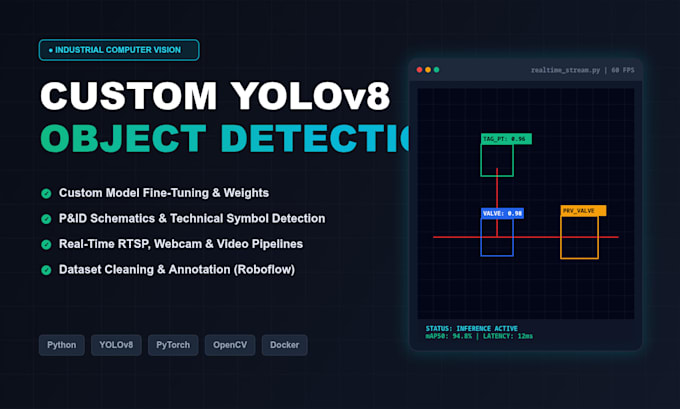
Suchst du nach einer einsatzbereiten Lösung für Computer Vision und Objekterkennung? Ich spezialisiere mich auf das Training, die Optimierung und den Einsatz von hochleistungsfähigen YOLO-Modellen, die genau auf deine individuellen Anforderungen zugeschnitten sind.
Mit industrieller Erfahrung in der Feinabstimmung von YOLO-Architekturen auf realen Datensätzen bei Larsen & Toubro Construction liefere ich robuste Pipelines, die auf Genauigkeit und geringe Latenz ausgelegt sind.
Angbotene Dienstleistungen:
Deployment-Verpackung via Docker-Container und REST-APIs
Technologie-Stack: Python, YOLOv8, PyTorch, OpenCV, Roboflow, CUDA, Docker
Warum dieses Gig wählen?
Bitte sende mir vor der Bestellung eine Nachricht mit deinen Datensatzdetails und Projektanforderungen, um den besten technischen Ansatz zu gewährleisten!
Expertise:
Bildverarbeitung
•
Objekterkennung
Programmiersprache:
Python
•
Colab
Tools:
Jupyter-Notizbuch
•
opencv
•
PyTorch
Frameworks:
scikit-learn
•
keras
•
PyTorch
•
Panda
Automatische Übersetzung
Was muss ich vor Beginn des Projekts bereitstellen?
Gib eine kurze Beschreibung der Objekte, die du erkennen möchtest, die Zielumgebung (Webcam, CCTV, Videodateien) und deinen Datensatz (Bilder oder Videomaterial). Falls du noch keinen annotierten Datensatz hast, wähle das Standard- oder Premium-Paket, damit die Datenbereinigung und Annotation für dich übernommen werden können.
Was, wenn mein Datensatz klein ist oder noch keine Labels hat?
Im Standard- und Premium-Paket werden Rohbilder bereinigt, mit Bounding-Boxen versehen und mit Roboflow und OpenCV augmentiert, um die Vielfalt des Datensatzes zu erhöhen und die Modell-Generalisierung zu verbessern.
Wie kann ich das Modell auf meinem Computer ausführen und testen?
Jedes Paket liefert sauberen, modularen Python-Quellcode, trainierte .pt Modellgewichte, eine requirements-Datei und klare Installationsanweisungen. Du erhältst ein einfaches Inferenz-Skript, mit dem du die Erkennung sofort auf Testbilder, Videos oder deiner Live-Webcam testen kannst.
Brauche ich eine teure GPU, um das Modell auszuführen?
Das Training erfolgt auf spezieller Hardware (wie CUDA/PyTorch-Umgebungen), aber das exportierte Modell kann Inferenz auf Standard-CPUs, lokalen GPUs oder Cloud-Servern durchführen. Wenn du niedrige Latenzzeiten benötigst, kann das Modell auch optimiert oder via Docker containerisiert werden, um eine leichte Bereitstellung zu gewährleisten.
Können wir individuelle Anforderungen vor der Bestellung besprechen?
Ja. Klicke auf den Button Kontakt zum Verkäufer, um dein Projekt, Beispielbilder oder spezielle Edge Cases vor der Bestellung zu senden, damit die passende Stufe und Architektur bestätigt werden können.