Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden
DevOps-Ingenieur für Terraform und CICD
Ist dein Kubernetes-Workload im CrashLoopBackOff hängen geblieben, scheitern Health Checks oder wird unvorhersehbar deployed?
Ich biete evidenzbasierte Troubleshooting- und Zuverlässigkeits-Audits für Engineering-Teams und SaaS-Entwickler, die Workloads auf AWS EKS, GCP GKE oder in eigenen Clustern laufen lassen.
Was ich liefere (pro Paket):
- Basic (Workload-Triage): Ursachenanalyse von 1 fehlerhaften Deployment, StatefulSet oder Job anhand deiner redigierten Manifestdateien, kubectl describe-Ausgabe und Logs mit getesteten YAML-Fixes.
- Standard (Reliability Audit): Audit von bis zu 5 Workloads bezüglich CPU/Memory-Requests & Limits, Liveness/Readiness Probes, HPA, PodDisruptionBudgets, RBAC und NetworkPolicies.
- Premium (EKS/GKE & GitOps-Review): Vollständige Cluster-Zuverlässigkeit, Argo CD / Rollouts-Drift, Canary-Rollback, Prometheus/OpenTelemetry-Observability und Workload Identity-Review.
Hintergrund & Abgrenzung:
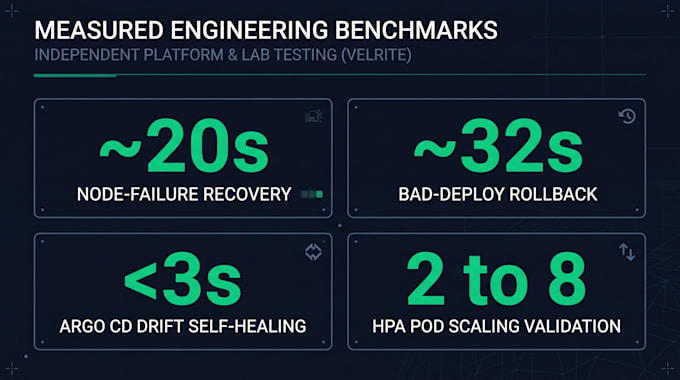
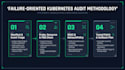
Meine fehlerorientierte Vorgehensweise stützt sich auf unabhängige Benchmark-Tests von GCP GKE & AWS EKS (Self-Healing, Argo CD-Drift-Selbstheilung und Scheduler-Rennen-Lösung). Ich führe keine unautorisierten Live-Produktionsänderungen durch; kontaktiere mich zuerst für individuelle Cluster-Ausführung.
Tools:
Kubernetes
•
Docker
•
Amazon EKS
•
Google Kubernetes Engine
Frameworks:
Npm
•
Terraform
•
Ansible
•
Koch
•
Crossplane
Programmiersprache:
Bash
•
C
•
Go
•
Java
•
JavaScript
•
PHP
•
Python
•
Golang
Expertise:
Debuggen
•
Konfiguration
Automatische Übersetzung
Brauchst du direkten Zugriff auf meinen Live-Produktions-Cluster?
Nein. Die meisten Reviews und Root-Cause-Triage erfolgen sicher offline mit deinen redigierten YAML/Helm-Manifests, kubectl describe-Ausgaben und Pod-Logs. Falls eine direkte Cluster-Verifizierung nötig ist, kläre ich zuerst einen eingeschränkten Lesezugriff oder Staging-Zugriff über ein individuelles Angebot.
Wie soll ich Konfigurationsdateien und Logs sicher teilen?
Reduziere immer Passwörter, API-Tokens, TLS-Private Keys und .env-Geheimnisse, bevor du Dateien hochlädst. Füttere Fiverr-Nachrichten oder Bestellanforderungen niemals mit Rohdaten.
Was, wenn dein Problem mehrere Mikroservices betrifft oder Hands-on-Fixes benötigt werden?
Basic deckt 1 Workload ab, Standard bis zu 5 Workloads. Wenn deine Umgebung Multi-Service-Remediation oder Live-Cluster-Ausführung erfordert, schick mir deinen Umfang und ich erstelle ein festpreisiges Custom Offer mit klarem Rollback-Plan.
Kannst du zero Downtime oder 100% Sicherheit nach der Review garantieren?
Kein ehrlicher Engineer kann Zero Downtime oder absolute Sicherheit garantieren. Was ich liefere, sind konkrete, getestete Konfigurationsfixes, priorisierte Risikofunde und dokumentierte Verifikationsschritte, damit dein Team bekannte Fehlermodi eliminieren kann.