Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden
Automatische Übersetzung
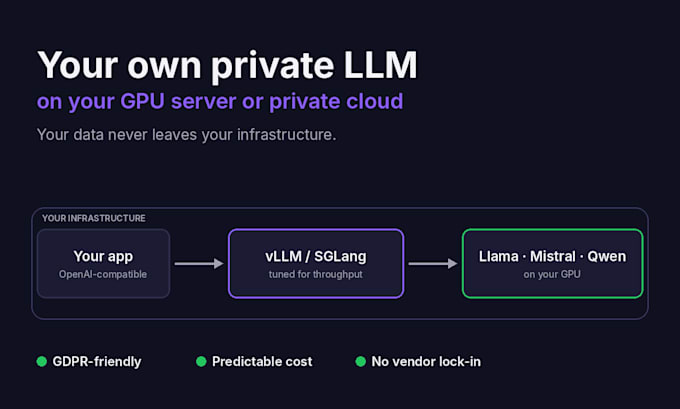
Möchtest du KI auf ChatGPT-Niveau, ohne deine Daten an OpenAI zu senden? Ich stelle einen Open-Source-LLM auf deinem eigenen GPU-Server oder privater Cloud bereit, damit Prompts und Dokumente nie deine Infrastruktur verlassen.
Ich bin AI-Ingenieur und habe eine souveräne KI-Plattform in Produktion für ein holländisches Hosting-Unternehmen mit über 1,4 Mio. Abonnenten aufgebaut und betrieben. Das ist echte Inferenz-Engineering-Arbeit, kein 1-Klick-Ollama-Installieren.
Was ich mache:
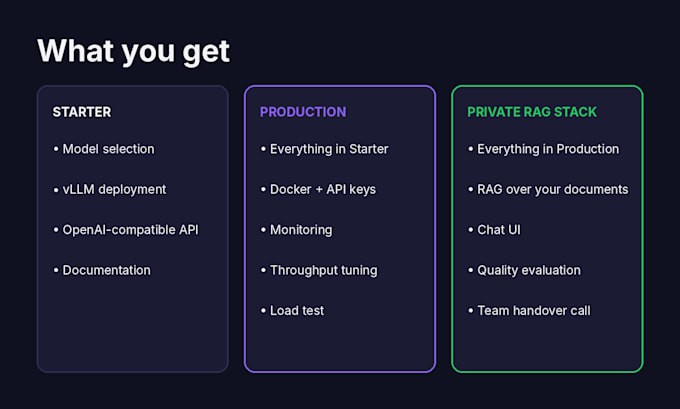
Das passende Modell für deine Aufgabe und Hardware auswählen (Llama, Mistral, Qwen, DeepSeek, Gemma)
Es hinter einer OpenAI-kompatiblen API mit vLLM oder SGLang bereitstellen, sodass dein vorhandener Code einfach funktioniert
Durchsatz, Latenz und GPU-Speicher optimieren (Quantisierung, KV-Cache, Batching)
Docker, API-Schlüssel, Monitoring und Lasttests für echten Traffic hinzufügen
Optional: RAG über deine eigenen Dokumente mit einer Chat-Oberfläche
Geeignet ist es für dich, wenn:
Du Datenschutz-, GDPR- oder Compliance-Anforderungen hast
Du zu viel für API-Tokens zahlst und stabile Kosten wünschst
Du bereits GPUs hast (on-prem, RunPod, Lambda, AWS, Hetzner) oder Hilfe bei der Auswahl brauchst
Bitte schreibe mir vor der Bestellung mit deinem Use Case und deiner Hardware, damit ich das passende Paket bestätigen kann.
Senior AIML Engineer
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Brauche ich meine eigene GPU?
Du brauchst Zugriff auf einen GPU-Server: On-Premises oder gemietet von Anbietern wie RunPod, Lambda, AWS oder Hetzner. Falls du noch keinen hast, empfehle ich dir vor der Bestellung das passende GPU-Modell und den passenden Provider entsprechend deinem Modell und Budget.
Funktioniert es mit meinem vorhandenen OpenAI-Code?
Ja. Die Bereitstellung bietet eine OpenAI-kompatible API, daher ändert sich in den meisten Fällen nur die Basis-URL und der Modellname im Code.
Welches Modell soll ich verwenden?
Das hängt von deiner Aufgabe, der Sprache und dem GPU-Speicher ab. Ich empfehle ein Modell (z. B. Llama, Mistral, Qwen, DeepSeek oder Gemma) und einen Quantisierungsgrad, damit du die beste Qualität bekommst, die deine Hardware schnell ausführen kann.
Wie greifst du auf meinen Server zu?
Über einen temporären SSH-Benutzer oder Cloud-Account mit nur den benötigten Rechten. Du kannst mir den Zugriff entfernen, sobald die Arbeit geliefert ist.
Wird ein selbst gehostetes Modell so gut sein wie GPT-4?
Für fokussierte Aufgaben wie Dokumenten-Q&A, Zusammenfassung oder Klassifizierung sind moderne Open-Modelle oft nah dran. Für breiteres logisches Denken kann es weniger mithalten. Sag dir vorab ehrlich, was du von deinem Use Case erwarten kannst, bevor wir starten.