Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD

Automatische Übersetzung
Hör auf, dich auf KI-Chatbots zu verlassen, die Halluzinationen erzeugen. Um echten Geschäftswert aus Large Language Models zu ziehen, müssen sie DEINE Daten verstehen.
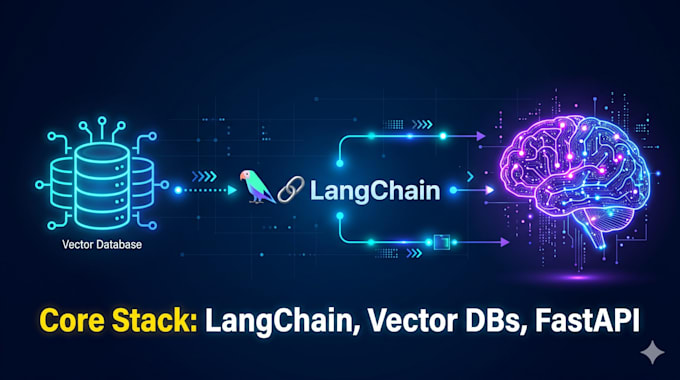
Ich entwickle maßgeschneiderte, produktionsreife KI-Agenten und Retrieval-Augmented Generation (RAG)-Pipelines, die sicher mit deiner firmeneigenen Wissensdatenbank integriert werden.
Als Principal AI/ML Engineer spezialisiere ich mich darauf, KI aus experimentellen Notizbüchern in hochskalierbare Softwareanwendungen zu überführen. In früheren kommerziellen Einsätzen hat meine maßgeschneiderte LLM-Architektur die Nutzerbindung um 40% gesteigert.
Woran ich arbeite:
Stack: Python, LangChain, OpenAI, FastAPI, Vector DBs, AWS.
Schreib mir deine Projektziele, und lass uns loslegen!
Generative AI, RAG, and Edge Computing Expert
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Sind meine proprietären Daten sicher? Werden sie zum Trainieren öffentlicher Modelle genutzt?
Ja, deine Daten sind absolut sicher. Ich baue RAG-Pipelines mit APIs auf Unternehmensebene und dedizierten Vector-Datenbanken. Deine Dokumente dienen ausschließlich dem Kontextabruf und werden niemals zum Trainieren von Basis-Modellen wie OpenAIs öffentlicher GPT verwendet.
Wie unterscheidet sich das von der Verwendung von Standard-ChatGPT?
Standard-LLMs halluzinieren oft Fakten und kennen deine internen Geschäftsprozesse nicht. Eine maßgeschneiderte RAG-Pipeline begrenzt die KI darauf, Antworten nur aus deinen bereitgestellten Dokumenten oder Datenbanken zu ziehen, was hochpräzise und faktenbasierte Antworten sicherstellt.
Welche Arten von Daten oder Dokumenten kann der AI-Agent verarbeiten?
Ich kann eine breite Palette von Datenquellen integrieren, darunter PDFs, CSV/Excel-Dateien, SQL-Datenbanken, Word-Dokumente und interne Wikis wie Notion oder Confluence.
Welche Technologiestack verwendest du, um das Backend zu erstellen?
Ich konzipiere diese Systeme mit Python, LangChain und LangGraph für die KI-Workflows. Für die Backend-Infrastruktur nutze ich FastAPI und Redis, damit die Anwendung hohen Verkehr (30+ RPS) mit geringer Latenz bewältigt und containerisiert mit Docker ist.
Hilfst du bei der Bereitstellung des Agents in der Cloud?
Ja. Wenn du das Premium Enterprise-Paket wählst, stelle ich eine vollständig containerisierte Docker-Umgebung und Deploy-Konfiguration bereit. Sie ist vollständig bereit, bei deinem bevorzugten Cloud-Anbieter wie AWS, GCP oder Azure zu hosten.