Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
KI- und ML-Ingenieur, Computer Vision und Deep Learning
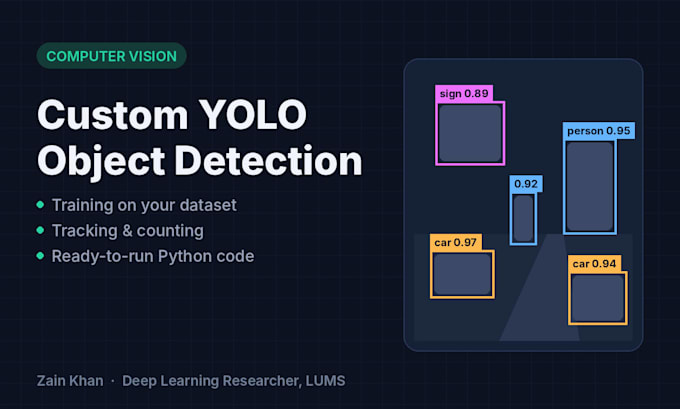
Suchst du ein Computer-Vision-Modell, das auf DEINEN Bildern oder Videos funktioniert? Ich bin Deep-Learning-Forscher an der LUMS (Lahore University of Management Sciences) und entwickle maßgeschneiderte YOLO-Modelle, die Objekte in realen Aufnahmen erkennen, verfolgen und zählen.
Was ich erstellen kann:
Was du bekommst:
Schreib mir vor der Bestellung ein paar Beispielbilder, damit ich bestätigen kann, welche Genauigkeit für deine Daten realistisch ist.

Programmiersprache:
Python
•
Colab
Tools:
Jupyter-Notizbuch
•
opencv
•
CVAT
•
PyTorch
Frameworks:
scikit-learn
•
keras
•
PyTorch
Automatische Übersetzung
Brauche ich ein gelabeltes Dataset?
Nein. Basic erfordert gelabelte Bilder, aber die Standard- und Premium-Pakete beinhalten Labeling. Wenn du nur Rohbilder oder Videos hast, schreib mir und ich schlage dir die beste Option vor.
Kann das Modell auf Video, CCTV oder Webcam laufen?
Ja. Jedes Paket enthält ein Inferenz-Skript, das auf Bildern, Videodateien und Live-Kameras oder RTSP-Streams funktioniert. Ich kann auch auf ONNX exportieren, um die Bereitstellung zu beschleunigen.
Was brauchst du von mir, um anzufangen?
Deine Bilder oder Videos (oder ein Link dazu), die Liste der Objekte, die erkannt werden sollen, und wie du das Modell verwenden möchtest. Ich bestätige die Machbarkeit, bevor wir beginnen.