Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Bengalischer AI-Trainer Übersetzer
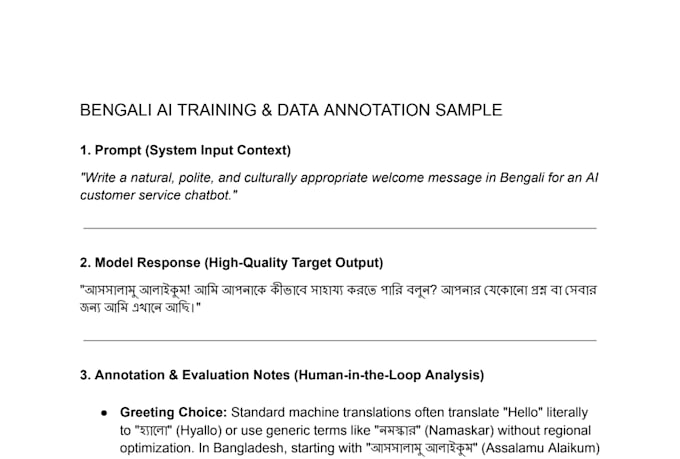
Suchst du einen bengalischen Muttersprachler, um Datensätze für deine LLM- und AI-Modelle zu verfeinern, zu annotieren oder zu bewerten? Du bist hier genau richtig!
AI-Modelle sind nur so gut wie die Daten, auf denen sie trainiert werden. Schlechte Übersetzungen, unnatürliche Syntax und kulturelle Fehler können die Leistung deines Modells ruinieren. Als bengalischer Muttersprachler mit tiefem Verständnis für sprachliche Nuancen biete ich hochwertige Datenservices an, um deine AI flüssig, natürlich und kulturell korrekt zu machen.
Was ich für dein AI-Projekt tun kann:
Warum du mich wählen solltest?


Technik:
Anleitung
Tagging-Typ:
Text
•
Bild
•
Audio
Automatische Übersetzung
Kannst du mit speziellen Datenannotierungsplattformen wie Labelbox, Scale AI oder benutzerdefinierten UIs arbeiten?
Ja, absolut. Ich bin sehr technikaffin und kann mich leicht an jede Drittanbieterplattform oder proprietäres Tool anpassen, das dein Unternehmen nutzt. Du kannst mich einfach per E-Mail zu deinem Workspace hinzufügen oder die Projektzugangsdaten teilen, und ich werde deine Richtlinien strikt befolgen.
Wie garantierst du die Qualität und Genauigkeit der bengalischen Trainingsdaten?
Als bengalischer Muttersprachler überprüfe ich jeden einzelnen Datenpunkt manuell. Ich lege großen Wert auf kontextuelle Genauigkeit, natürliche Grammatiksyntax und richtige Sentiment-Ausrichtung. Ich verwende niemals automatisierte Tools, Bots oder maschinelle Übersetzer für meine Arbeit, um hochwertige Daten für dein LLM zu gewährleisten.
Unterschreibst du Non-Disclosure Agreements (NDAs) für sensible oder proprietäre Datensätze?
Ja, ich verstehe, dass Trainingsdatensätze wertvolles geistiges Eigentum sind. Ich behandle alle Kundendaten mit höchster Vertraulichkeit. Wenn dein Team ein NDA vor der Datenfreigabe unterzeichnen lassen möchte, bin ich offen, es zu prüfen und zu unterschreiben.
Kannst du große Datensatzprojekte oder langfristige Verträge übernehmen?
Ja! Während meine Paketstufen bestimmte Mengen abdecken, kann ich viel größere Volumen durch individuelle Meilensteine bewältigen. Für laufende Projekte oder riesige Datensätze sende mir bitte eine Nachricht mit deinen Anforderungen, Richtlinien und Zeitplan, damit ich dir ein maßgeschneidertes Angebot erstellen kann.