Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden
Datenanalyst und Data Scientist
Ich erstelle Klassifikations-, Regressions- und Clustering-Modelle für tabellarische Daten in Python. R ist auf Absprache verfügbar.
Inklusive: explorative Datenanalyse (EDA), vereinbarte Bereinigung und Vorverarbeitung, Modelltraining, Auswertung und Optimierung. Du erhältst kommentierten Code, Dokumentation und klare Erklärungen zu Ergebnissen und Einschränkungen.
Jedes Paket deckt 1 Tabelle und 1 Vorhersageziel bzw. Clustering-Frage ab:
Eingabespalten werden vor der Codierung gezählt; die Zielspalte wird bei Bedarf zusätzlich erhoben. Deine Daten müssen nicht modellbereit sein.
Formate: CSV, Excel oder SPSS (.sav).
Sende mir vor der Beauftragung eine Nachricht mit deinem Ziel, Dateiformat, Abmessungen und einer anonymisierten Probe. Wir bestätigen zuerst Machbarkeit und Umfang der Vorverarbeitung. Tabellenzusammenführung, manuelle Datenrekonstruktion und Datenbankextraktion erfordern ein separates Angebot.
Portfolio-Beispiel: LearnerCue
https://tonywillert.github.io/Portfolio/#learnercue


Programmiersprache:
Python
•
R
•
SQL
•
NoSQL
Frameworks:
scikit-learn
•
keras
•
PyTorch
•
Panda
Tools:
Jupyter-Notizbuch
•
tensorflow
•
Excel
•
RStudio
Automatische Übersetzung
Welche Machine-Learning-Aufgaben bietest du an?
Ich baue Klassifikations-, Regressions- und Clustering-Modelle für strukturierte, tabellarische Daten. Typische Ziele sind das Vorhersagen eines Ergebnisses, das Schätzen eines Wertes oder das Identifizieren von Gruppen. Jede Bestellung deckt eine vereinbarte Vorhersageziel- oder Clustering-Frage ab.
Müssen meine Daten zuerst bereinigt werden?
Nein. Deine Daten sollten eine strukturierte Tabelle sein, aber sie müssen nicht modellbereit sein. EDA und vereinbarte Vorverarbeitung sind in den Paketgrenzen enthalten, z. B. Reinigung, Umgang mit fehlenden Werten, Kodierung von Kategorien und Skalierung von Merkmalen.
Wie werden die Paketgrenzen gezählt?
Jedes Paket deckt eine Tabelle ab. Grenzen: Basic 2.000 Zeilen/10 Eingabespalten; Standard 10.000/20; Premium 30.000/30. Kopfzeilen zählen nicht als Zeilen. Eingabespalten werden vor der Kodierung gezählt; eine Zielspalte ist je nach Bedarf zusätzlich.
Was erhalte ich bei jedem Paket?
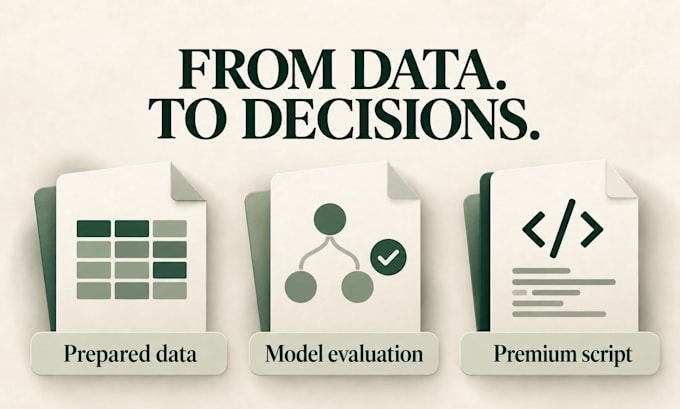
Alle Pakete enthalten kommentierten Code, Auswertungsergebnisse und Dokumentation. Basic deckt einen Algorithmus ab; Standard und Premium bis drei. Premium ergänzt ein wiederverwendbares Vorhersageskript und eine Anleitung für Daten mit derselben Struktur. Wiederholte Fits während der Feinabstimmung zählen als derselbe Algorithmus.
Welche Dateiformate und Sprachen unterstützt du?
Ich akzeptiere CSV, Excel (.xlsx) und SPSS (.sav). Python ist Standard; R ist nach Vereinbarung verfügbar. Ein Datenwörterbuch ist hilfreich. Datenbankextraktion, Tabellenzusammenführung und manuelle Datenrekonstruktion benötigen einen separaten Umfang und ein Angebot vor der Bestellung.
Kannst du eine bestimmte Genauigkeit garantieren?
Es wird kein spezifischer Score oder Geschäftsergebnis garantiert. Die Leistung hängt von der Datenqualität, verfügbaren Informationen und der Aufgabe ab. Wir prüfen die Machbarkeit vor der Bestellung. Ich verwende geeignete Validierung und erkläre die gemessene Leistung und Einschränkungen.
Was beinhaltet eine Revision?
Eine Revision ist eine zusammengeführte Runde von Anpassungen im vereinbarten Umfang. Basic und Standard beinhalten eine; Premium beinhaltet zwei. Neue Analysen, Datensätze, Ziele oder Deliverables benötigen ein separates Angebot. Fehler bei der Umsetzung der vereinbarten Arbeiten werden korrigiert.
Sind Deployment und laufende Wartung inklusive?
Die Pakete umfassen Modellentwicklung und Übergabe. Cloud-Deployment, API-Integration, geplante Läufe, laufende Überwachung und Wartung liegen außerhalb des Umfangs. Feinabstimmung vortrainierter Modelle ist ebenfalls separat. Bitte bespreche diese Anforderungen vor der Bestellung.
Was soll ich vor der Bestellung senden?
Schick mir dein Ziel, Dateiformat, Zeilen- und Spaltenanzahl, Spaltenbeschreibungen und eine kleine synthetische oder vollständig anonymisierte Probe, die du teilen darfst. Wir bestätigen Machbarkeit, Vorbereitungsbedarf, passende Dateien und die Übertragungsmethode, bevor die Arbeit beginnt.