Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden
Full-Stack Web, DevOps und KI-Automatisierung, The Burujan
Betrugsverluste tun weh, doch genauso Blockaden durch Falschmeldungen, die gute Kunden abschrecken. Ich baue ein Machine-Learning-Modell zur Betrugserkennung in Python, das mehr Betrug erkennt und weniger echte Kunden fälschlich markiert.
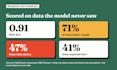
Ich bin Huzaifa von The Burujan, ein NOC-Ingenieur, der Data-Science-Projekte entwickelt. Mein Betrugserkennung-Projekt für Kreditkarten nutzt 590.540 echte Kartentransaktionen, bei denen nur 3,5% Betrug sind. In einem späteren Testdatensatz, den das Modell vorher nicht gesehen hat, erreichte es 0,91 ROC AUC, fing 71% des Betrugsgeldes ab und senkte Falschalarme im Vergleich zu einem Standardmodell bei derselben Betrugsgeld-Erfassung um 47%.
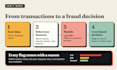
Was du bekommst: Datenbereinigung, Verhaltensmerkmale wie Ausgabeverlauf und Geschwindigkeit, Umgang mit Klassenungleichgewicht, abgestimmte LightGBM- und XGBoost-Modelle, eine Entscheidungs-Schwelle basierend auf deiner Kostenstrategie von Betrug gegenüber Falschalarm, SHAP-Erklärungen, damit Analysten sehen, warum jede Transaktion markiert wurde, und ein Bericht mit einem Jupyter-Notebook. Premium enthält eine Scoring-API, einen Überwachungsplan und eine Anleitung zum Retraining.
Ich teile die Daten zeitlich statt zufällig, damit die Ergebnisse ehrlich sind. Kein Modell kann zero fraud versprechen, und die Ergebnisse hängen von deinen Daten ab. Schreibe mir vor der Bestellung mit einer kurzen Beschreibung deiner Daten, dann sage ich dir, ob es passt.
Expertise:
Klassifizierung
•
Ausreißererkennung
•
Prädiktive Analyse
Programmiersprache:
Python
•
SQL
Frameworks:
scikit-learn
Tools:
Jupyter-Notizbuch
•
Colab
Automatische Übersetzung
Welche Daten muss ich angeben?
Eine Tabelle vergangener Transaktionen mit Betrug-Label (0 oder 1) als CSV- oder Datenbank-Export. Mehrere Monate Historie mit Zeitstempeln und Beträgen funktionieren am besten. Karten-, Geräte- und E-Mail-Felder helfen, sind aber optional.
Schneidet das Modell wirklich Falschalarme?</faq_1_question_translated_to_de>
In meinem Projekt senkte es die Falschalarme um 47% gegenüber einem Standardmodell bei derselben Betrugs-Erfassung, auf einem späteren Testdatensatz. Ergebnisse hängen von deinen Daten ab, daher nenne ich dieselben Messgrößen auch für deine eigenen Daten.
Kannst du es als API bereitstellen?
Ja. Das Premium-Paket beinhaltet eine Scoring-API mit Übergabedokumenten. Ich arbeite in Python mit LightGBM, XGBoost und scikit-learn und passe deinen Stack an, wenn du mir sagst, was du verwendest.


