Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD


Automatische Übersetzung
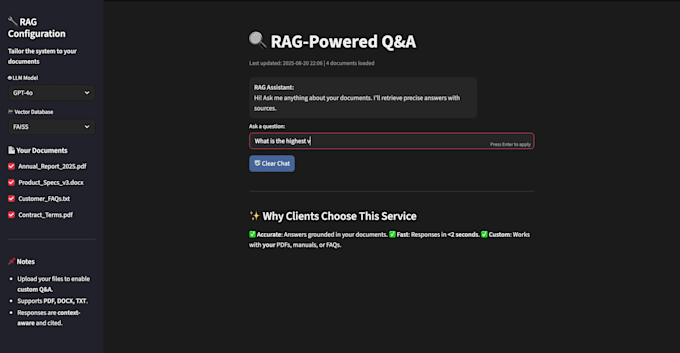
Willst du deine KI-Anwendungen mit Retrieval-Augmented Generation (RAG) auf das nächste Level bringen? Du bist hier genau richtig!
Ich entwerfe und implementiere eine produktionsbereite RAG-Pipeline, die die Kraft von Large Language Models (LLMs) mit intelligenten Retrieval-Systemen kombiniert, damit deine KI präzise, kontextbezogene und aktuelle Antworten liefern kann.
Was ich anbiete:
End-to-End RAG-Pipeline-Entwicklung (Retriever + Generator)
Integration mit Vektordatenbanken (Pinecone, Weaviate, FAISS, Milvus usw.)
Dokumentenaufnahme & Chunking mit Embeddings
API-fertige Bereitstellung (FastAPI/Flask)
Feinabstimmung für domänenspezifische Anwendungsfälle
Erklärbare KI-Integration für Transparenz
Optimierung für Skalierbarkeit & Latenz
Anwendungsfälle:
Warum mich wählen?
Als Experte für ML/AI-Ingenieur und Python-Entwickler habe ich realistische RAG-Lösungen gebaut, die skalierbar, flexibel und auf Geschäftsbedürfnisse zugeschnitten sind. Ich sorge für sauberen, dokumentierten und produktionsbereiten Code, damit du mit Vertrauen skalieren kannst.
Hi, I'm Tauseef Ahmed, an AI ML engineer with 7 years of experience
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Was ist eine RAG-Lösung?
Eine RAG (Retrieval-Augmented Generation)-Lösung kombiniert einen Retriever (der relevante Kenntnisse aus einer Datenbank abruft) mit einem Generator (wie GPT), um präzise, kontextbezogene und zuverlässige Antworten zu liefern.
Warum brauche ich RAG statt eines normalen LLM?
Standard-LLMs können Halluzinationen haben oder veraltete Antworten geben. Mit RAG hat deine KI Zugriff auf Echtzeit-, domänenspezifisches Wissen, was Genauigkeit, Vertrauenswürdigkeit und weniger Halluzinationen garantiert.
Welche Vektor-Datenbanken unterstützt du?
Ich unterstütze Pinecone, Weaviate, FAISS, Milvus, Chroma und ElasticSearch. Wenn du eine andere im Sinn hast, kann ich sie ebenfalls integrieren.
Kannst du die Lösung in Produktion bringen?
Ja! Ich kann deine RAG-Pipeline als API (FastAPI/Flask) bereitstellen, in Chatbots oder Web-Apps integrieren und für Skalierbarkeit in Cloud-Umgebungen (AWS, GCP, Azure usw.) einrichten (nur spezieller Plan).
Brauche ich ein eigenes LLM oder können wir OpenAI/andere nutzen?
Beides ist möglich! Ich kann OpenAI, Anthropic, Cohere, HuggingFace-Modelle oder dein eigenes feinabgestimmtes LLM je nach Bedarf integrieren.
Kannst du es domänenspezifisch machen (rechtlich, medizinisch, finanziell usw.)?
Absolut ✅. Ich kann Embeddings, Retrieval-Logik und Pipeline-Setup für domänenspezifische Anwendungen feinabstimmen, damit deine RAG-Lösung perfekt zu deiner Branche passt.
Wie gewährleisten Sie Datenschutz und Sicherheit?
Ich verwende sichere Pipelines, private Vektorspeicher und zugriffskontrollierte APIs, um deine sensiblen Daten zu schützen. Deployment kann auf deinen Servern oder Cloud-Konten erfolgen, für vollständige Kontrolle.
Was benötige ich für den Anfang?
Teile mir einfach deine Anforderungen, verfügbare Daten (Dokumente, Wissensdatenbank usw.) und deine bevorzugte Technik-Stack mit. Ich leite dich durch den Rest!