Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden
KI-Ingenieur, LLM-, RAG- und NLP-Entwickler
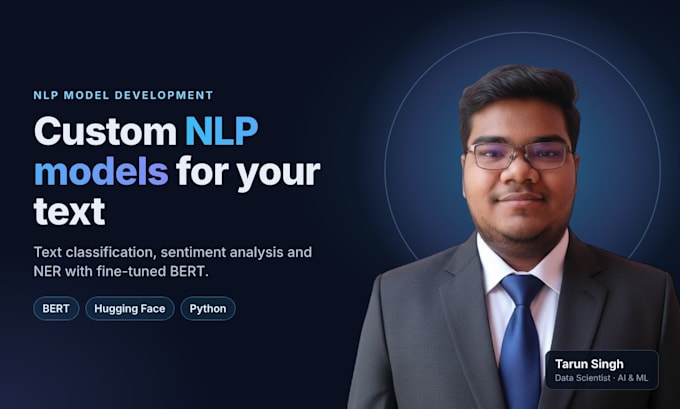
Benötigst du ein Modell, das deinen Text versteht: Rezensionen, Support-Tickets, E-Mails, Kommentare oder Dokumente?
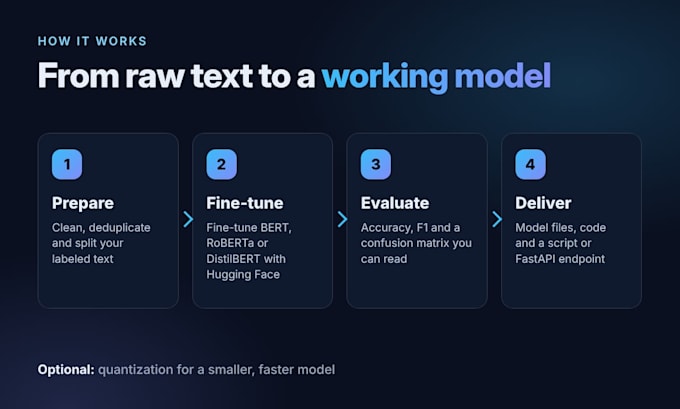
Ich baue und feintune NLP-Modelle mit BERT, RoBERTa und DistilBERT, die Rohtext in präzise Vorhersagen verwandeln.
Was ich erstellen kann:
Was du bekommst:
Warum ich?
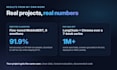
Ich bin Data Scientist und arbeite jeden Tag an NLP und LLMs. Ich habe MobileBERT auf 91,9% Genauigkeit bei der 6-Klassen-Emotions-Erkennung feinjustiert, danach die Größe mit Quantisierung halbiert und 91,1% behalten. Bei der Arbeit baue ich LangChain-LLM-Pipelines und FastAPI-Dienste, die produktiv laufen.
Schreibe mir deine Daten und dein Ziel vor der Bestellung, dann schlage ich dir das passende Package vor.
Programmiersprache:
Python
•
SQL
•
Colab
•
NoSQL
•
MLflow
Frameworks:
scikit-learn
•
keras
•
PyTorch
•
Panda
Tools:
Jupyter-Notizbuch
•
tensorflow
•
Excel
•
MLflow
•
Colab
Automatische Übersetzung
Welche Daten muss ich angeben?
Eine CSV- oder Excel-Datei mit deinem Text und Labels funktioniert am besten. Keine Labels vorhanden? Ich schlage dir einen Label-Plan vor oder nutze Zero-shot- bzw. LLM-basierte Methoden, um dir den Einstieg zu erleichtern.
Welche Modelle verwendest du?
BERT, RoBERTa, DistilBERT oder MobileBERT und Open-Source-LLMs wie Llama oder Mistral über Hugging Face. Ich wähle das kleinste Modell, das deinen Genauigkeits- und Geschwindigkeitserfordernissen genügt.
Kannst du eine bestimmte Genauigkeit garantieren?
Niemand kann ehrlich eine Genauigkeit vor dem Blick auf die Daten versprechen. Ich teile früh einen Baseline-Wert, erkläre die Ergebnisse klar und verbessere das Modell innerhalb deiner Paket-Revisionen.
Wird es möglich sein, das Modell selbst auszuführen?
Ja. Du erhältst trainierte Modell-Dateien, den Code und ein einfaches Inferenz-Skript. Standard fügt einen FastAPI-Endpunkt hinzu, und Premium fügt Docker- und Cloud-Deployment hinzu.
Arbeiten Sie mit anderen Sprachen als Englisch?
Ja. Ich verwende mehrsprachige Modelle wie XLM-RoBERTa und mBERT, auch Hindi und andere indische Sprachen.
Werden meine Daten vertraulich behandelt?
Deine Daten werden ausschließlich für dein Projekt verwendet und niemals weitergegeben. Ich lösche meine Kopien nach der Lieferung, wenn du es wünschst.