Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden
KI- und ML-Ingenieur, KI-Chatbots, KI-Agenten und Computer Vision
Suchst du nach einem Modell, das bestimmte Objekte in deinen Bildern oder Videos finden kann? Ich trainiere individuelle YOLO-Objekt-Erkennungsmodelle mit deinen eigenen Daten und übergebe dir eine Lösung, die du tatsächlich laufen lassen kannst.
Was ich bauen kann:
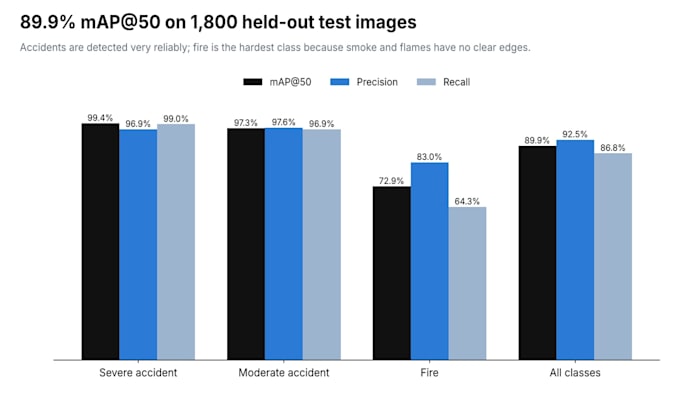
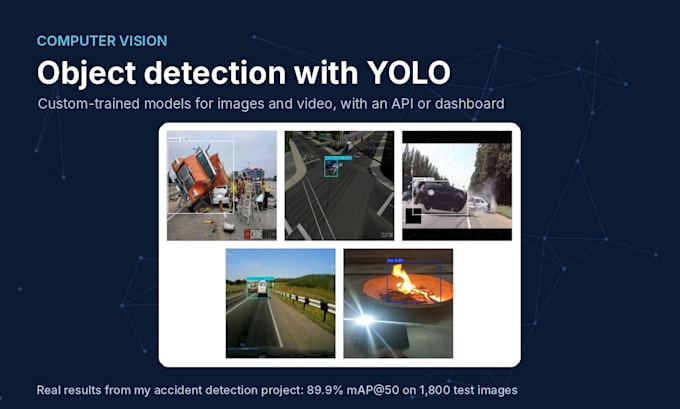
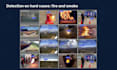
Aktuelle Arbeit: Mein Abschlussprojekt erkennt Unfälle auf der Straße und Feuer in Videos in Echtzeit. Das YOLOv12-Modell erreichte 89,9% mAP@50 und 92,5% Präzision auf 1.800 Testbildern.
So funktioniert es:
Bitte schreibe mir vor der Bestellung, damit wir die Klassen und Datenmenge abstimmen können.
Programmiersprache:
Python
•
Colab
Tools:
Jupyter-Notizbuch
•
opencv
•
CVAT
•
PyTorch
Frameworks:
scikit-learn
•
PyTorch
•
Panda
Automatische Übersetzung
Wie viele Bilder brauche ich?
In der Regel sind ein paar hundert gelabelte Beispiele pro Objekt ein guter Start. Wenn du weniger hast, schick, was vorhanden ist, und ich sage dir ehrlich, ob es ausreicht oder wie du mehr sammeln kannst.
Kann es auch mit Live-Video oder einer Webcam funktionieren?
Ja. Ich kann das Modell so einrichten, dass es auf Videodateien, eine Webcam oder einen Kamerastream läuft. Die Geschwindigkeit hängt von deiner Hardware ab, daher teste ich es und nenne dir die erwarteten Bilder pro Sekunde.