Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Großbritannien
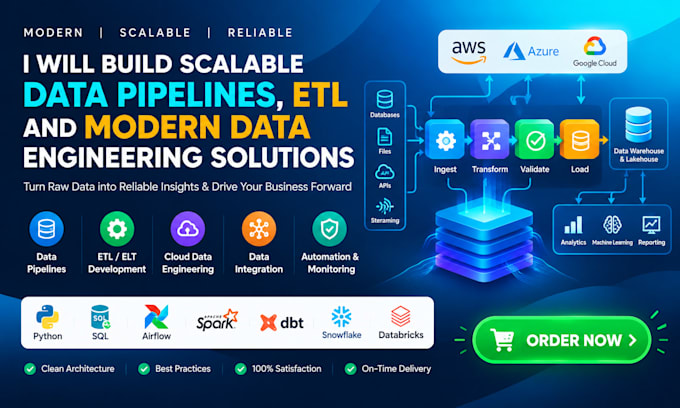
Skalierbare Datenpipelines und moderne Cloud-Datenplattformen aufbauen
Benötigst du zuverlässige Data Pipelines, die Rohdaten in saubere, nutzbare Erkenntnisse verwandeln?
Ich bin Susan, eine Data Engineering Spezialistin, die Unternehmen beim Aufbau skalierbarer, automatisierter und produktionsbereiter Datenlösungen unterstützt.
WAS ICH BAUEN WERDE:
WARUM MIT MIR ZUSAMMENARBEITEN?
Du erhältst saubere, zuverlässige und wartbare Data Pipelines, die auf deine Geschäftsanforderungen zugeschnitten sind und keine generischen Lösungen darstellen.
Egal, ob du eine ETL-Pipeline, Datenintegration, Datenmigration, analytics-ready Daten oder eine moderne Data Engineering Lösung brauchst – ich helfe dir, eine skalierbare Basis zu schaffen.
Sende mir deine Datenquellen, Anforderungen oder Architektur, und lass uns eine zuverlässige Data Pipeline bauen, die mit deinem Geschäft wächst.
JETZT KONTAKTIERE MICH!!!!
Automatische Übersetzung
Kannst du eine skalierbare Data Pipeline für mein Unternehmen bauen?
Ja. Ich baue skalierbare ETL/ELT Data Pipelines für Datenbanken, APIs, Dateien und Cloud-Plattformen mit Python, SQL und modernen Data Engineering Tools. Deine Pipeline kann Datenaufnahme, Transformation, Validierung, Automatisierung und Monitoring umfassen.
Was ist in deinem ETL- und Data Engineering-Service enthalten?
Ich kann Datenextraktion, ETL/ELT, Datenintegration, Transformation, Validierung, Automatisierung und Pipeline-Orchestrierung übernehmen. Ich kann deine Quellen auch mit einem Data Warehouse, Data Lake oder Cloud-Datenplattform verbinden.
Kannst du ETL-Pipelines mit Python und SQL bauen?
Ja. Ich nutze Python und SQL, um zuverlässige ETL/ELT Pipelines zu erstellen, Datenworkflows zu automatisieren, Datensätze zu transformieren und saubere, analytics-ready Daten für Lager, Lakes und moderne Cloud-Plattformen vorzubereiten.
Kannst du APIs, Datenbanken und mehrere Datenquellen integrieren?
Ja. Ich kann APIs, SQL/NoSQL-Datenbanken, CSV/Excel-Dateien und Cloud-Datenquellen in automatisierte Data Pipelines integrieren, um einen zuverlässigen Fluss von sauberen und strukturierten Daten für Analytics und Reporting zu schaffen.
Kannst du Airflow, Spark, dbt oder andere Data Engineering Tools verwenden?
Ja. Je nach deinen Anforderungen kann ich Apache Airflow, Spark, PySpark, dbt und andere moderne Data Engineering Tools für Pipeline-Orchestrierung, Transformation, Automatisierung, Tests und skalierbare Datenverarbeitung nutzen.
Kannst du Cloud Data Pipelines für AWS, Azure oder GCP bauen?
Ja. Ich kann cloud-ready Data Pipelines für AWS, Azure und Google Cloud entwerfen, inklusive Datenaufnahme, ETL/ELT, Transformation, Integration und Analytics-Workflows basierend auf deiner Architektur und deinen Geschäftsanforderungen.
Kannst du meine Data Pipeline mit Snowflake, BigQuery oder Databricks verbinden?
Ja. Ich kann Pipelines bauen, die Daten für moderne Plattformen wie Snowflake, BigQuery und Databricks laden und transformieren, um skalierbare, zentrale und analytics-ready Datenumgebungen zu schaffen.
Kannst du eine bestehende Data Pipeline automatisieren und optimieren?
Ja. Ich kann deine bestehende ETL/Data Pipeline überprüfen, Engpässe identifizieren und Automatisierung, Zuverlässigkeit, Leistung und Datenqualität verbessern. Sende mir deinen aktuellen Workflow und deine Anforderungen für eine maßgeschneiderte Lösung.