Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden
Python‑AI-Ingenieur für MCP, Claude Code und Computer Vision
Bilder von Hand zu labeln wird langsam und teuer, sobald der Datensatz einige hundert Bilder überschreitet. Ich nutze Vision-Modelle wie SAM 2 und Grounding DINO, um deine Bilder oder Video-Frames vorzu-labeln, prüfe dann eine zufällige Stichprobe von Hand und sage dir die gefundene Fehlerrate.
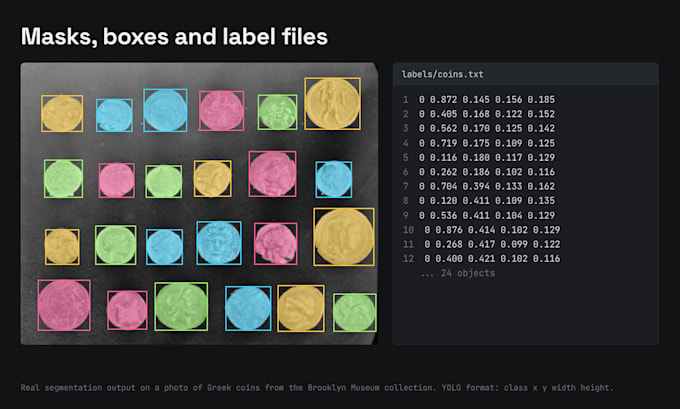
Du erhältst Bounding-Boxen oder Segmentierungs-Masken für deine Klassen, exportiert im YOLO-, COCO- oder Pascal VOC-Format, in einer Ordnerstruktur, auf der du direkt trainieren kannst. Ich kann den Datensatz auch in Training-, Validierungs- und Testdaten aufteilen.
Da ich Python-Bild- und Video-Pipelines erstelle, kümmere ich mich auch um die Vorbereitungsarbeit: Frames aus Videos extrahieren, nahe Duplikate entfernen und Dateinamen bereinigen.
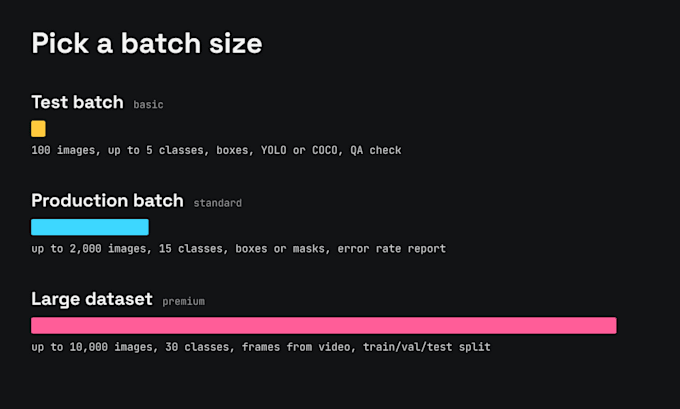
KI-Pre-Labeling funktioniert am besten, wenn Objekte klare Kanten haben. Falls du dir nicht sicher bist, ob deine Daten passen, fang mit dem 100-Bilder-Testbatch an oder schreib mir zuerst ein paar Muster, dann sage ich dir, was du erwarten kannst.
Technik:
Automatisiert
Tagging-Typ:
Bild
•
Video
Automatische Übersetzung
Welche Formate liefern Sie?
YOLO (txt), COCO (JSON) und Pascal VOC (XML). Sag mir Bescheid, falls du ein anderes Format brauchst.
Wie genau sind die AI-Pre-Labels?
Es kommt darauf an, wie eindeutig deine Objekte sind. Ich überprüfe zufällig eine Stichprobe von Hand, korrigiere die Labels, die ich prüfe, und melde die Fehlerrate, damit du weißt, was du bekommst.
Kannst du auch Videos labeln?
Ja. Ich extrahiere Frames in dem von dir gewählten Intervall und labelle diese Frames.
Was passiert mit meinen Bildern?
Sie werden nur für deinen Auftrag verwendet und nach Lieferung gelöscht, wenn du darum bittest.
Kannst du ein Modell mit den labelten Daten trainieren?
Ja. Schreib mir für ein individuelles Angebot, um ein YOLO-Modell auf deinem Datensatz zu trainieren.