Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden
Datenwissenschaftler
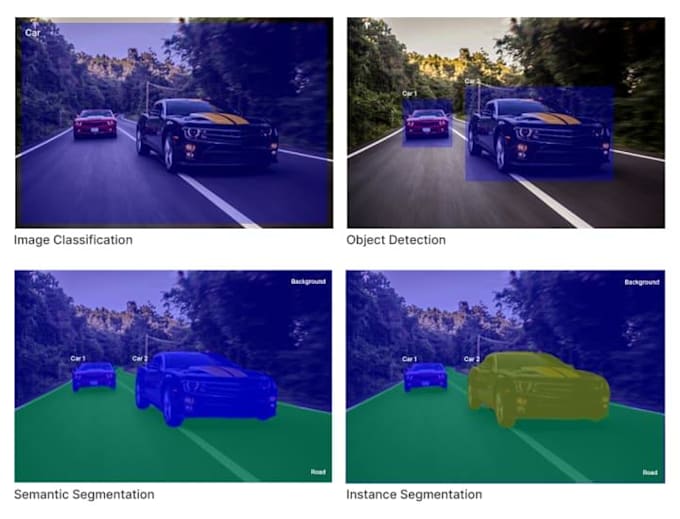
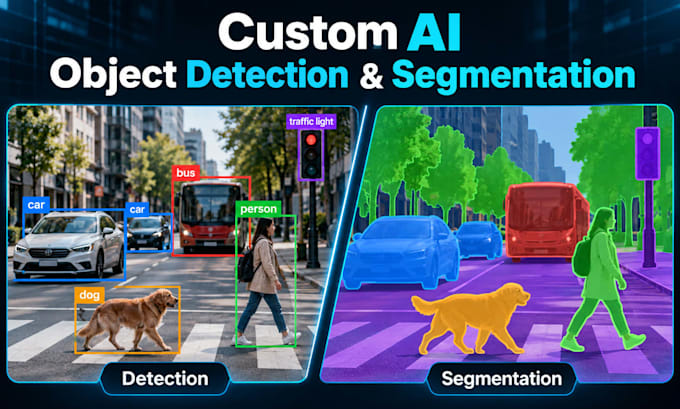
Braucht du ein individuelles Computer-Vision-Modell, um Objekte in Bildern oder Videos zu erkennen oder zu segmentieren?
Ich erstelle, trainiere und feine feine Modelle für Objekterkennung und Segmentierung, die genau auf deine Bedürfnisse zugeschnitten sind.
Was ich anbiete:
Was du erhältst:
Je nach Paket: trainierte Modellgewichte, Python-Quellcode, Muster-Vorhersagen, Evaluationskennzahlen und Dokumentation.
Datensatz-Anforderungen:
Du kannst gelabelte oder unlabeled Bilder oder Videos bereitstellen. Die Dataset-Annotation ist als optionale kostenpflichtige Zusatzleistung verfügbar, die Preise richten sich nach Datenmenge und Komplexität.
Die Modellleistung hängt von der Datenqualität und der Aufgabenschwierigkeit ab; genaue Genauigkeitswerte können nicht garantiert werden.
Bitte kontaktiere mich vor der Bestellung, um deinen Datensatz, Ziele und Anforderungen zu besprechen.

Programmiersprache:
Python
•
R
•
SQL
•
Colab
•
MLflow
Automatische Übersetzung
Was brauchen Sie, um mein Projekt zu starten?
Bitte teile mir deine Projektziele, einen gelabelten Datensatz oder Muster, die Objekte, die du erkennen oder segmentieren willst, und dein bevorzugtes Ausgabeformat mit. Ich prüfe die Anforderungen, bevor ich den Umfang bestätige.
Kannst du sowohl mit Bildern als auch mit Videos arbeiten?
Ja. Ich kann Modelle für Bilder bauen und auf Videoframes anwenden. Objektnachverfolgung, temporäre Video-Segmentierung und Echtzeit-Kamera-Systeme benötigen eine separate Vereinbarung.
Muss ich unbedingt einen annotierten Datensatz bereitstellen?
Nein. Modelltraining erfordert geeignete gelabelte Bilder oder Video-Frames. Wenn dein Datensatz nicht annotiert ist, kontaktiere mich bitte, um eine separate Vorbereitung und Annotation zu besprechen.
Bekomme ich das trainierte Modell und den Quellcode?
Ja. Alle Pakete enthalten Modellgewichte, Python-Quellcode und Nutzungsanleitungen. Erweiterte Auswertung, Video-Inferenz und API-Integration hängen vom gewählten Paket ab.
Kannst du eine bestimmte Modellgenauigkeit garantieren?
Nein. Die Genauigkeit hängt von der Qualität des Datensatzes, der Größe, dem Klassen-Balance und der Aufgabenschwierigkeit ab. Ich werte das Modell mit passenden Metriken aus und teile die Ergebnisse mit deinem Paket.