Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Machine Learning Ingenieur
Suchst du einen Experten für Machine Learning, um individuelle ML-Modelle zu entwickeln, LLMs feinabzustimmen oder Produktions-KI-Pipelines zu deployen? Du bist hier genau richtig!
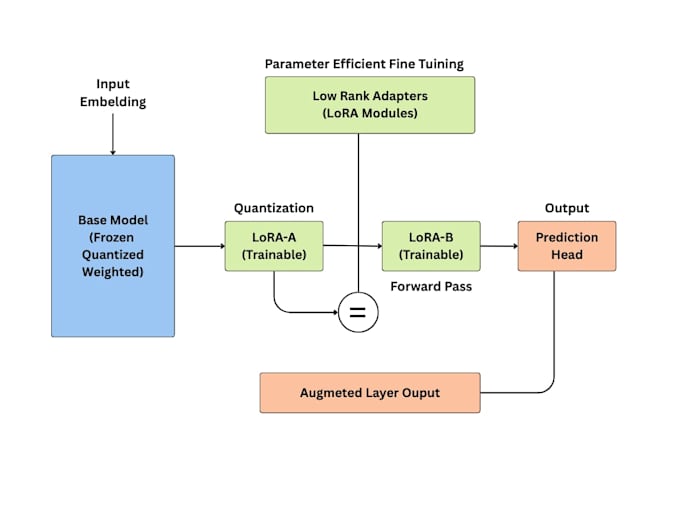
Ich spezialisiere mich auf die Entwicklung von End-to-End-Lösungen im Bereich Machine Learning und Generative AI, die genau auf deine geschäftlichen oder forschungsbezogenen Bedürfnisse zugeschnitten sind. Von Datenbereinigung bis hin zu parameter-effizientem Feinabstimmen (QLoRA/LoRA) und API-Deployment liefere ich sauberen, produktionsbereiten Code.
Was ich anbiete:
Warum du mich wählen solltest?



Programmiersprache:
Python
•
SQL
Frameworks:
scikit-learn
•
keras
•
PyTorch
•
Panda
•
Andere
Tools:
Jupyter-Notizbuch
•
opencv
•
Excel
•
CVAT
•
Colab
Automatische Übersetzung
Welche Informationen oder Dateien muss ich vor der Bestellung bereitstellen?
Bitte gib eine klare Beschreibung deiner Projektziele, deiner Dataset (falls vorhanden) und etwaiger spezifischer Leistungsmetriken oder Rechenbeschränkungen (z.B. GPU-Speicher, Cloud-Umgebung). Falls du noch kein Dataset hast, kann ich bei der Datensammlung oder -vorverarbeitung beraten.
Kannst du Large Language Models (LLMs) auf individuelle Datensätze feinabstimmen?
Ja! Ich spezialisiere mich auf parameter-effiziente Feinabstimmung (PEFT) mit QLoRA und LoRA-Techniken auf Modellen wie Llama 3, Mistral und Hugging Face-Architekturen. Ich optimiere Modelle, damit sie effizient auf Low-Resource-GPUs (z.B. einzelne T4 GPU) laufen, bei gleichzeitiger hoher Genauigkeit.
Welche Frameworks für Machine Learning und Deep Learning nutzt du?
Ich arbeite hauptsächlich mit Python, PyTorch, TensorFlow, Scikit-Learn, Hugging Face Transformers, OpenCV und FAISS für Vektorsuche. Für Web-API-Deployment nutze ich Flask und FastAPI.
Bekomme ich den vollständigen Quellcode und die Modelldateien?
Ja! Jedes Paket enthält sauberen, vollständig dokumentierten Python-Quellcode (Jupyter Notebooks oder modulare Skripte) sowie trainierte Modelgewichte und Schritt-für-Schritt-Anleitungen zur Einrichtung.
Kannst du das ML-Modell in eine funktionierende Webanwendung oder API integrieren?
Absolut. Im Premium-Paket (oder via Gig Extras) kann ich ein Flask- oder FastAPI-Backend aufbauen, interaktive Dashboards mit Streamlit erstellen oder Docker-Container für nahtlose Deployments einrichten.
Was, wenn mein Dataset unordentlich, unformatiert oder unvollständig ist?
Kein Problem! Datenvorverarbeitung, Umgang mit fehlenden Werten, Feature Engineering und Datenbereinigung sind Kernbestandteile meines ML-Workflows in allen Paketen.
Wie stellen wir die Modellqualität und -leistung sicher?
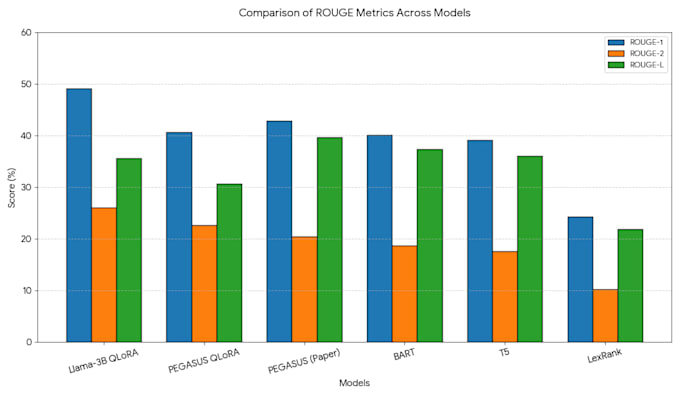
Ich bewerte Modelle anhand gängiger Metriken (Genauigkeit, Präzision, Recall, F1-Score, ROUGE für NLP oder R² für Regression) und verfolge Experimente, um reproduzierbare, optimale Ergebnisse zu gewährleisten.