Kategorien durchsuchen
Deutsch
$
USD
Verbinden Sie sich mit Ihrer KI
Automatische Übersetzung
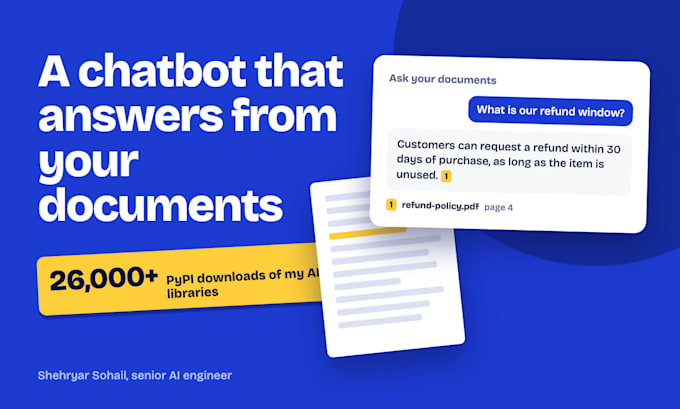
Ich erstelle Dokumenten-Chatbots, die ausschließlich aus deinen Dateien antworten und anzeigen, woher jede Antwort stammt.
Relevante Arbeiten: Ich habe SkyLocker gebaut, einen WhatsApp-Assistenten, der Dateien der Nutzer speichert, durchsucht und mit multimodalem RAG über Text und Bilder zurückgibt (Milvus, ChromaDB, OpenAI, S3). Außerdem pflege ich ocr-llm, eine Open-Source-Bibliothek, die unordentliche und gescannte PDFs in sauberes Markdown umwandelt – mit Vision-LLMs (über 3.000 PyPI-Downloads). Das ist wichtig, weil schlechtes PDF-Parsing der Bereich ist, in dem die meisten Dokumenten-Chatbots stille scheitern.
Was du bekommst: Deine PDFs und Textdateien werden geparst, gechunkt und indexiert; ein Chatbot, der die passenden Passagen abrufbar macht und nur daraus antwortet; eine Zitation zu jeder Antwort; und ein ehrliches 'Ich weiß es nicht', wenn deine Dokumente die Frage nicht abdecken. Es kann auf deiner Website, WhatsApp oder Slack laufen.
Wie ich arbeite: Wir legen die Dokumente und die zu lösenden Fragen fest, ich baue es, teste es anschließend mit echten Fragen aus deinen Dokumenten, bevor ich übergebe.
Stack: OpenAI oder Claude, Python, FastAPI, Vektor-Datenbanken (pgvector, Pinecone, Milvus), Next.js Widget.
Schreib mir vor der Bestellung mit deinen Dokumenten und deinem Use Case, dann sag ich dir, welches Paket passt.
AI engineer: voice agents, LLM apps, RAG and document extraction
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Kann es gescannte PDFs lesen?
Ja, auch vom Standardpaket an aufwärts. Ich verwende Vision-LLMs, um gescannte Seiten zuerst in sauberen Text umzuwandeln – derselbe Ansatz wie in meiner Open-Source-Bibliothek ocr-llm.
Was passiert, wenn die Antwort nicht in meinen Dokumenten steht?
Es sagt ‚Ich weiß es nicht‘ statt zu raten. Antworten stammen nur aus deinem Inhalt, und jede Antwort zeigt das verwendete Dokument und die Passage.
