Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Forschungsenthusiast
Benötigst du eine robuste medizinische Bildverarbeitungs-Pipeline vom Rohscanner-Ausgang bis zu trainierten neuronalen Netzen?
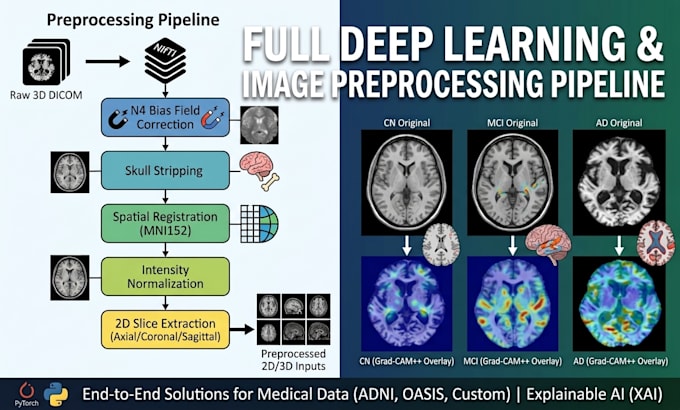
Rohscans (DICOM / NIfTI) können ohne richtige räumliche Ausrichtung und Intensitätsnormalisierung nicht direkt in Deep-Learning-Modelle eingespeist werden. Ich erstelle vollständige medizinische Computer-Vision-Pipelines, die Datenvorverarbeitung, individuelles Architekturdesign und Modellinterpretierbarkeit abdecken.
1. Datenvorverarbeitung:
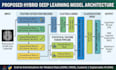
2. Deep Learning & Klassifikation:
3. Explainable AI (XAI):
Lieferumfang:
Bitte schreibe mir vor der Bestellung, um deine Daten und Anforderungen zu besprechen!
Automatische Übersetzung
Welche medizinischen Bildformate kannst du verarbeiten?
Ich kann Standard-Formate medizinischer Rohbilder verarbeiten, einschließlich DICOM (.dcm), NIfTI (.nii, .nii.gz), NRRD sowie 2D-Bildformate (PNG, JPEG, TIFF). Egal, ob dein Dataset aus 3D-Volumenaufnahmen oder extrahierten 2D-Slice-Sets besteht, ich kann eine automatisierte Pipeline dafür erstellen.
Enthält deine Pipeline Vorverarbeitung wie Schädelentfernung oder Bias-Korrektur?
Ja. Rohmedizinische Scans benötigen eine Standardisierung, bevor sie in Deep-Learning-Modelle eingespeist werden. Mein Vorverarbeitungsworkflow umfasst DICOM-zu-NIfTI-Konvertierung, räumliche Neuausrichtung (RAS-Ausrichtung), N4 Bias-Feld-Korrektur, Schädelentfernung / Hirnauszug, MNI152-Registrierung und Intensitätsnormalisierung.
Welche Deep-Learning-Frameworks und Bibliotheken verwendest du?
Ich erstelle hauptsächlich modulare, reproduzierbare Pipelines in Python mit PyTorch, OpenCV, SimpleITK, NiBabel, NumPy und scikit-learn. Wenn du speziell TensorFlow oder Keras benötigst, kann ich die Modellarchitektur auf dein bevorzugtes Framework anpassen.
Wie gehst du mit Klassenungleichgewicht in medizinischen Datensätzen um?
Ungleichgewichtige Klassen (z.B. weniger kranke Proben als normale Kontrollen) können Deep-Learning-Modelle stark verzerren. Ich mindere das durch technische Strategien wie Weighted Random Sampling bei der Batch-Erstellung, klassengewichtete Kreuzentropie-Verluste und Datenaugmentation, um das Ungleichgewicht auszugleichen.
Was ist Explainable AI (Grad-CAM++) und warum brauche ich das?
Deep Neural Networks werden oft als "Black Boxes" kritisiert. Grad-CAM++ erzeugt Klassenaktivierungs-Hitmaps direkt über deinen MRI/CT-Scans, um genau die Gehirn- oder Anatomie-Regionen (wie Gewebeatrophie oder vergrößerte Ventrikel) visuell hervorzuheben, die die Vorhersage des Modells antreiben. Diese Interpretation hilft dir, die Entscheidungen des Modells besser zu verstehen.
Stellst du medizinische Diagnosen oder klinische Patientenbewertungen bereit?
Nein. In voller Übereinstimmung mit den Fiverr-Richtlinien biete ich keine klinischen Diagnosedienste, Patientenberatung oder medizinische Ratschläge an. Meine Leistungen beschränken sich strikt auf Softwareentwicklung, Datenvorverarbeitung, Modellarchitektur und akademische/F&E-technische Unterstützung.
Welche Ergebnisse erhalte ich, wenn die Bestellung abgeschlossen ist?
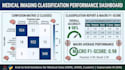
Abhängig von deinem gewählten Paket erhältst du vollständig modulare, saubere Python-Quellcodes (oder Jupyter Notebooks), trainierte Modellgewichtdateien (.pt oder .h5), Skripte für die Datenvorverarbeitung, visuelle Auswertungsergebnisse (Verwirrungsmatrix, Verlust-/Genauigkeitskurven, ROC-Kurven) und Grad-CAM++ Hitmaps.
Können wir eine NDA unterschreiben oder sicherstellen, dass mein proprietärer Forschungsdatensatz privat bleibt?
Absolut. Ich nehme den Datenschutz ernst. Dein Dataset und dein Projektcode bleiben zu 100 % vertraulich und werden niemals geteilt, veröffentlicht oder in irgendeiner Form wiederverwendet. Ich bin bereit, vor dem Versand der Dateien eine Geheimhaltungsvereinbarung (NDA) zu unterschreiben.