Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden
Automatische Übersetzung
Mach Routine-Arbeiten mit Dokumenten und Ordnern wiederkehrend leichter.
Ich baue einen lokalen Python-Workflow, um bestehenden Text aus digitalen PDFs zu extrahieren, ein Verzeichnis zu inventarisieren, identische Inhalte zu erkennen oder eine organisierte Ordnerkopie nach vereinbarten Regeln zu erstellen.
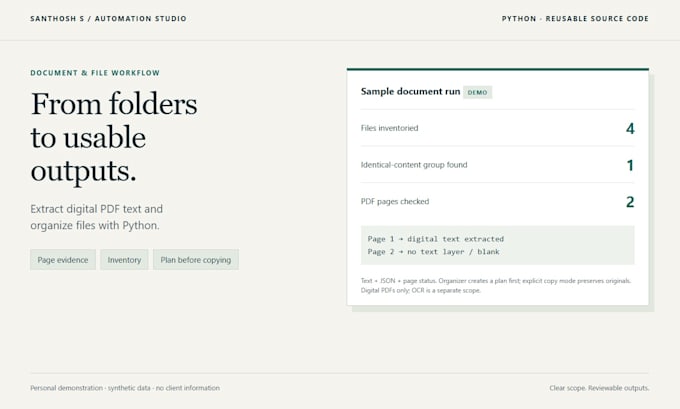
Ausgaben können eine TXT-Datei pro Dokument, eine Seiten-JSON, eine Status-CSV und eine Inventarliste mit relativen Pfaden, Größen und SHA-256-Fingerabdrücken umfassen. Leere Seiten oder Seiten ohne extrahierbaren Inhalt werden markiert.
Der Organizer erstellt zuerst einen prüfbaren Plan. Der explizite Copy-Modus bewahrt Originale und überprüft die Ergebnisse. Er verschiebt oder löscht dein Quelldatmaterial nicht.
Du erhältst wiederverwendbaren Code, Run-Anleitungen, Beispielausgaben und eine Zusammenfassung. Meine persönliche Demo verwendet synthetische Daten: Vier inventarisierte Items und eine zwei-Seiten-Probe, inklusive einer leeren Seite.
Scans, OCR, Handschrift, Tabellenrekonstruktion, verschlossene Dokumente und Web-Scraping benötigen separate Abgrenzung. Die Lese-Reihenfolge hängt von der ursprünglichen Struktur ab.
Premium beinhaltet einen Windows-Setup-Guide und 14 Tage Fehlerbehebungen im gelieferten Umfang.
Schick eine bereinigte Musterdatei, Counts, Gesamtgröße und dein gewünschtes Output vor der Auswahl eines Packages.
Senior Executive
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Kannst du gescannte PDFs oder Bilder verarbeiten?
Dieses Paket deckt digitale PDFs mit vorhandener Texthülle ab. Scans und Handschrift benötigen einen separat abgegrenzten OCR-Workflow. Seiten ohne Text werden markiert statt erraten.
Werden Tabellen und das ursprüngliche PDF-Layout beibehalten?
Nein. Die Ausgabe ist extrahierter Text mit Seitenbelegen. Die Lese-Reihenfolge variiert, und Tabellenrekonstruktion bzw. Layout-Wahrung erfordert eine separate, fallbasierte Abgrenzung.
Wird der Organizer meine Dateien verschieben oder löschen?
Nein. Der Standardlauf erstellt einen Plan. Ein expliziter Copy-Lauf erzeugt organisierte Kopien und verifiziert Inhalts-Hashes; Originale bleiben erhalten. Duplizierte Inhalte werden nur gemeldet.
Kann ich die Automatisierung erneut ausführen?
Ja. Quellcode in Python und eine Laufanleitung sind dabei. Eingaben müssen die vereinbarte Struktur behalten, und jeder Durchlauf schreibt in einen neuen oder leeren Ausgabeordner.
Welche Organisationsregeln sind enthalten?
Premium deckt Gruppierung nach Dateierweiterung oder modifiziertem UTC-Monat ab, bei gleichzeitiger Beibehaltung der ursprünglichen relativen Ordnerstruktur. Geschäftspezifische Klassifikation oder PDF-Feldextraktion sind separat abgegrenzt.
Welche Dateien soll ich teilen?
Schick zuerst eine bereinigte, repräsentative Musterdatei und Counts. Stelle ungeschützte PDF-Kopien zur Verfügung. Übergebe keine Passwörter oder unnötige persönliche Daten. Wir bestätigen den Umfang vor der Verarbeitung des gesamten Batches.
Was sind die Date-, Seiten- und Größenlimits?
Basis: 20 PDFs/100 Seiten/50 MB. Standard: 100 PDFs/500 Seiten/200 MB plus 1.000 Inventar-Dateien. Premium: 200 PDFs/1.000 Seiten/300 MB plus 5.000 Inventar-Dateien und bis zu 2 GB Kopien. Sowohl PDF-Anzahl- als auch Gesamtseiten-Grenzen gelten.
