Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Level 1
Automatische Übersetzung
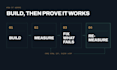
Die meisten KI-Systeme werden ausgeliefert, ohne dass jemand überprüft, ob sie tatsächlich funktionieren. Sie bestehen eine Demo, liefern dann die falsche Passage bei einer echten Frage, oder ein Agent ergreift die falsche Maßnahme.
Ich baue deine und beweise, dass sie funktioniert.
WAS ICH BAUE
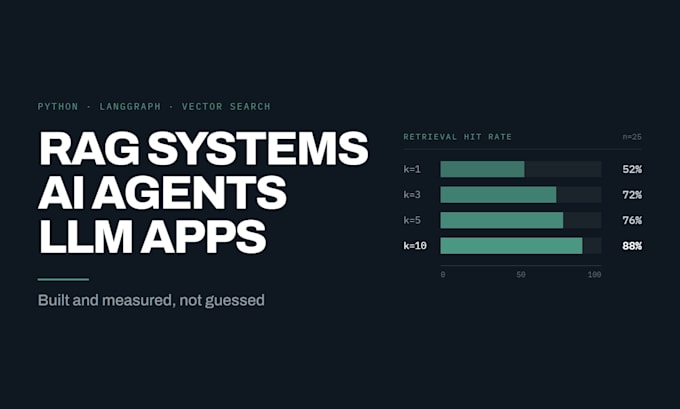
RAG-Systeme über deine Dokumente. KI-Agenten, die Werkzeuge nutzen und Mehrschritt-Aktionen ausführen. LLM-Anwendungen – Extraktion, Klassifikation, Zusammenfassung, Chat-Interfaces. Quellcode in jedem Paket.
WAS DAS AUSMACHT
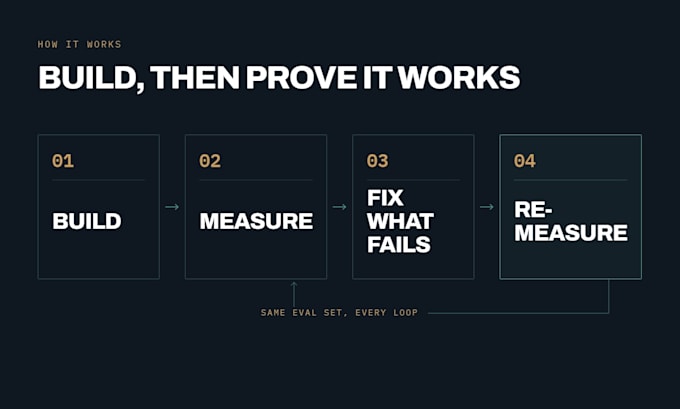
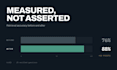
Bei Standard und Premium erstelle ich einen Evaluationssatz aus deinen echten Fragen und messe die Genauigkeit vor der Lieferung. Du bekommst Zahlen, keine Versprechen.
AUCH
Hast du schon ein RAG-System oder einen Agenten, der sich falsch verhält? Ich diagnostiziere warum – Chunking, Embeddings, Retrieval, Ranking oder Tool-Auswahl – behebe die häufigste Fehlerquelle und messe erneut. Schreib mir, bevor du bestellst.
STACK
Python, LangChain, LangGraph, pgvector, Chroma, Hybrid Search, Cross-Encoder-Reranking, mehrsprachiger Retrieval. AWS Bedrock, FastAPI, Docker. Claude, OpenAI, Hugging Face.
HINTERGRUND
KI/ML-Ingenieur, der an Produktions-KI-Systemen arbeitet. AWS Certified Machine Learning – Specialty.
Sag mir, was du baust oder was nicht funktioniert.
AI and ML Engineer, RAG and LLM Systems
Level 1
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Was benötigen Sie von mir, um zu beginnen?
Deine Dokumente (PDF, Word, HTML, Datenbank oder eine Webseite zum Crawlen) und ein Gefühl dafür, welche Fragen deine Nutzer tatsächlich stellen werden. Wenn du echte Nutzerfragen oder Support-Tickets hast, schick sie mir — sie machen das System messbar besser, weil ich den Evaluationssatz daraus erstelle.
Wie misst du die Genauigkeit? Was bedeutet das eigentlich?
Ich erstelle einen Fragenkatalog mit verifizierten Antworten aus deinen eigenen Dokumenten und messe, wie oft das System die richtige Passage findet. Wenn diese Passage nie das Modell erreicht, kann kein Prompt-Engineering die Antwort verbessern. Du bekommst die Zahl vor der Lieferung.
Meine Dokumente sind nicht auf Englisch. Macht das einen Unterschied?
Ja, mehr als die meisten erwarten. Die Qualität des Retrievals kann zwischen Sprachen erheblich variieren, selbst bei demselben Korpus und Modell. Ich arbeite regelmäßig mit mehrsprachigem Retrieval und messe pro Sprache, anstatt eine Zahl für beide zu nehmen.
Kannst du mein bestehendes RAG-System reparieren, anstatt ein neues zu bauen?
Ja. Schreib mir vorher, damit wir den Umfang klären können – der Preis hängt davon ab, ob es um Chunking, Embeddings, Retrieval-Konfiguration oder eine upstream-Parsing-Änderung geht. Ich diagnostiziere vor dem Angebot.
Wird er Dinge erfinden?
Nicht im Stillen. Ich baue Verweigerungsverhalten ein, sodass das System sagt, wenn die Antwort nicht in deinen Dokumenten ist, anstatt eine zu erfinden, und die Quellen angibt. Das ist eine Design-Anforderung, kein nachträglicher Gedanke.
Bekomme ich den Code?
Ja, in jedem Paket. Du besitzt, was ich baue, und kannst es selbst hosten, modifizieren und erweitern.