Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden
Dateningenieur
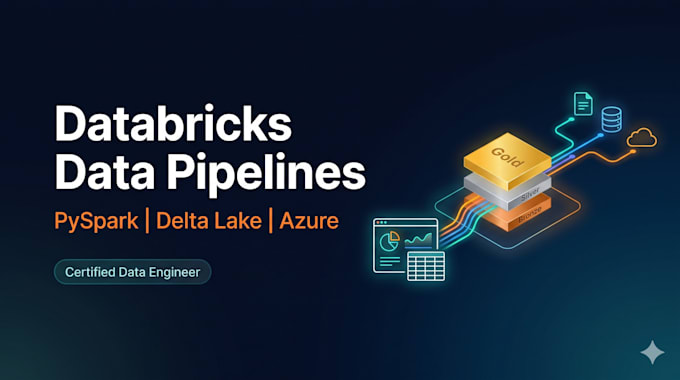
Suchst du einen erfahrenen Databricks-Dateningenieur, der eine zuverlässige, skalierbare Pipeline aufbaut? Ich bin Databricks Certified Data Engineer und habe über 5 Jahre Erfahrung im Aufbau von ETL-Pipelines in großem Umfang mit PySpark, Spark SQL und Delta Lake für globale Kunden aus Finanz- und Gesundheitswesen.
Was ich liefere:
Warum mit mir arbeiten:
Wenn du mehr als 3 Quellen hast oder benutzerdefinierte Anforderungen hast, erstelle ich dir ein individuelles Angebot.
Automatische Übersetzung
Welche Cloud-Plattform unterstützt du?
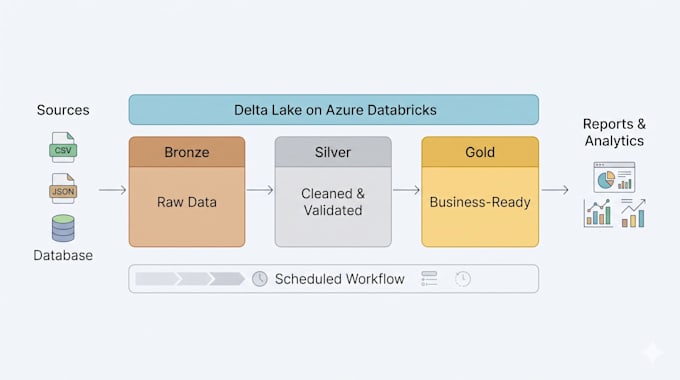
Ich spezialisiere mich auf Azure Databricks, einschließlich ADLS Gen2-Speicher und Azure Data Factory.
Was ist, wenn ich mehr als 3 Datenquellen habe?
Schreib mir vor der Bestellung deine Anforderungen, dann schicke ich dir ein maßgeschneidertes Angebot.
Was bekomme ich am Ende?
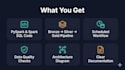
PySpark/Spark SQL-Notebooks, ein geplanter Databricks-Workflow, ein Architekturdiagramm und Dokumentation, die erklärt, wie man die Pipeline ausführt und wartet.
Kannst du mit meinem bestehenden Datenformat arbeiten?
Ja. Ich kann CSV, JSON, Parquet, Delta und Datenbanktabellen einlesen. Teile vor der Bestellung ein Beispiel, wenn dein Format ungewöhnlich ist.