Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Senior AI DevOps Engineer: AWS, Kubernetes, ComfyUI APIs, DevSecOps
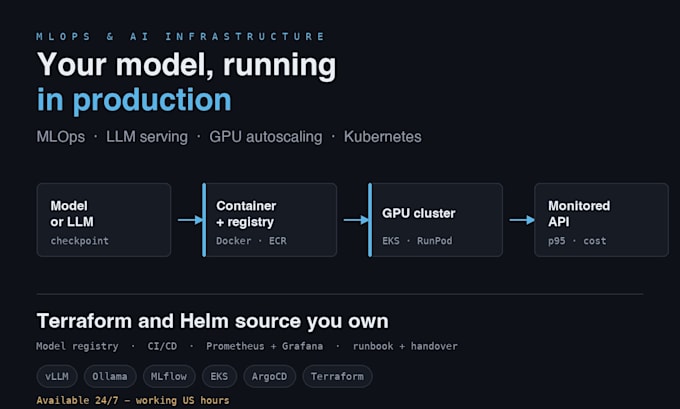
Ich bringe KI-Modelle in die Produktion und halte sie am Laufen. Ein Trainingsskript ist kein Produkt. Ein überwacht, versioniertes, autoskalierendes Service ist es.
Tools:
Kubernetes
•
Docker
•
Amazon EKS
Frameworks:
Terraform
•
Ansible
Programmiersprache:
Bash
•
Go
•
Python
Expertise:
Installation
•
Migration
•
Debuggen
Automatische Übersetzung
Welche Modelle kannst du bereitstellen?
Jedes offene Modell auf Hugging Face plus Llama, Mistral, Qwen, DeepSeek und deine eigenen Fine-Tunes. Für Bilder und Videos kümmere ich mich auch um Flux, SDXL und Wan. Sag mir das Modell und ich bestätige die GPU, die es braucht.
Brauche ich ein eigenes Cloud-Konto?
Ja, und das ist absichtlich so. Alles läuft in deinem AWS-, GCP- oder RunPod-Konto, damit du die Infrastruktur besitzt und die Abrechnung kontrollierst. Ich richte es ein und übergebe es dir.
Was kostet der Betrieb pro Monat?
Das hängt von der Modellgröße und dem Traffic ab. Vor deiner Bestellung gebe ich dir eine Größenabschätzung: GPU-Typ, erwartete Nutzung und eine monatliche Spanne. Spot-Instanzen und Skalierung auf null reduzieren die Kosten meist erheblich.
Bekomme ich die Terraform- und Helm-Source?
Immer. Du erhältst das vollständige Repository, Dockerfiles, Terraform- oder Helm-Charts und API-Dokumentation, damit du oder ein anderer Entwickler es später warten können.
Kannst du eine bestehende Einrichtung reparieren, anstatt eine neue zu bauen?
Ja. Fehlerhafte Deployments, Out-of-Memory-Crashes, GPU-Knoten, die nicht geplant werden, unkontrollierte Cloud-Rechnungen und undocumented Infrastruktur gehören zu meinen Hauptaufgaben.
Machst du selbst gehostete LLMs vor Ort?
Ja. Ollama oder vLLM mit Open WebUI auf deinem eigenen Server oder GPU-Arbeitsstation, vollständig offline, ohne dass Daten dein Netzwerk verlassen.
Welche Überwachung bekomme ich?
Prometheus und Grafana mit Dashboards für Latenz, Durchsatz, GPU-Auslastung, Fehlerquote und Kosten pro Anfrage, plus Alerts, die dich erreichen, bevor deine Nutzer es bemerken.
Wie sind Ihre Arbeitszeiten?
Ich bin 24/7 erreichbar und arbeite US-Zeiten, sodass wir in deiner Zeitzone sprechen können. Ich antworte in der Regel innerhalb einer Stunde.
