Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Systeme und ML-Projekte in C Python SQL pünktlich und optimiert
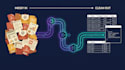
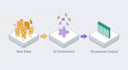
Daten in PDFs, E-Mails oder Dokumenten, die du nicht nutzen kannst? Ich erstelle AI-gestützte Python-Pipelines, die deine unstrukturierten Daten extrahieren, bereinigen und strukturieren und sie dorthin liefern, wo du sie brauchst.
WAS ICH BAUE
PDF-, E-Mail- & Dokumenten-Extraktion
Web-Scraping + strukturierte Ausgabe
LLM-Klassifikation, Tagging & Zusammenfassung
Datenbereinigung & Duplikatentfernung
Multi-Source-Merging & API-Integration
Automatisierte Planung (täglich, wöchentlich, bei Trigger)
Ausgabe an PostgreSQL, BigQuery, Excel, Sheets, S3, Airtable
WARUM KI IN DEINER PIPELINE?
Traditionelles ETL scheitert bei unstrukturierten Daten. KI-Verbesserung bedeutet:
Felder aus Freitext extrahieren – keine zerbrechlichen Regex
Automatische Klassifizierung und Labeling von Datensätzen in großem Maßstab
Umgang mit inkonsistenten Formaten automatisch
Anomalien erkennen, bevor sie in deiner Datenbank landen
WAS DU BEKOMMST
Sauberer Python-Code, den du behalten kannst
Dokumentierte, wartbare Pipeline
Getestete Ausgabe mit Beispiel-Daten
Support nach der Lieferung
Sende mir zuerst eine Nachricht mit deiner Datenquelle, was du extrahieren möchtest und wohin die Ausgabe gehen soll.

Automatische Übersetzung
Welche Eingabeformate unterstützt du?
PDFs, Word-Dokumente, Excel/CSV-Dateien, Klartext, E-Mails (EML/MSG), Webseiten, REST-APIs, Datenbanken (PostgreSQL, MySQL, MongoDB) und Cloud-Speicher (S3, Google Drive). Falls dein Format nicht aufgelistet ist, schick mir eine Nachricht, ich habe noch keines gefunden, mit dem ich nicht arbeiten kann.
Was bedeutet "KI-Verbesserung" eigentlich innerhalb einer Pipeline?
Es bedeutet, ein Sprachmodell als Transformationsschritt zu verwenden – nicht als Chatbot, sondern als Extraktionsmaschine. Statt fragilen Regeln zu schreiben, um einen Anbieter-Namen aus einer unordentlichen Rechnung zu ziehen, liest das Modell den Text und liefert ein sauberes, strukturiertes Feld.
Werde ich der Eigentümer des Codes sein?
Ja, der vollständige Quellcode ist bei jeder Bestellung enthalten. Es ist sauberer, dokumentierter Python-Code, den du nach der Lieferung eigenständig lesen, modifizieren und ausführen kannst, ohne versteckte Abhängigkeiten.
Kann die Pipeline automatisch nach einem Zeitplan laufen?
Ja – Standard- und Premium-Pakete beinhalten automatisierte Planung. Ich kann es so konfigurieren, dass es täglich, wöchentlich oder bei einem Trigger läuft (z.B. wenn eine neue Datei in einen Ordner landet oder ein Webhook ausgelöst wird). Basic ist standardmäßig einmalig, aber Planung kann als Extra hinzugefügt werden.
Was ist, wenn mein Datenvolumen sehr groß ist?
Sende mir zuerst eine Nachricht mit dem ungefähren Volumen. Für große Datensätze baue ich Pipelines mit Batch-Verarbeitung, Retry-Logik und kostenbewusstem API-Einsatz, damit deine KI-Verbesserungskosten vorhersehbar bleiben, ohne Überraschungsrechnungen.
Brauche ich einen eigenen AI-API-Schlüssel?
Es kommt darauf an. Für leichte Aufgaben kann ich Open-Weight-Modelle ohne Schlüssel verwenden. Für GPT-4 oder Claude-ähnliche Verbesserungen benötigst du deinen eigenen Schlüssel. Ich sage dir genau, welches du brauchst und ungefähr, was es für dein Volumen kosten wird, bevor du bestellst.


