Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden
Senior Data Engineer, der sich auf Cloud ETL und Architektur spezialisiert hat
Noch immer langsame SQL-Server-Refreshes?
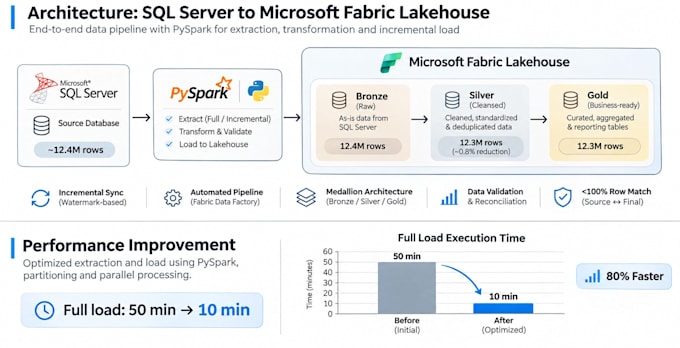
Ich migriere deine SQL-Server-Tabellen zu Microsoft Fabric Delta Lake, und erstelle optimierte Full-Load- und watermark-basierte inkrementelle Pipelines.
Was ich liefere:
Meine praktische Erfahrung: Fabric-Pipelines mit gestageten Upserts und inkrementellem Laden aufgebaut, Durchlaufzeit durch Optimierung von ca. 50 auf ca. 10 Minuten reduziert.
Ideal für Teams, die Legacy-SQL-Server- und SSIS-Workflows modernisieren.
Gib dein Schema und deine Zeilenanzahl durch, um loszulegen. Schreib mir, bevor du eine größere Migration bestellst.
Warehouse-Plattform:
Azure Synapse
•
Fabric Warehouse
•
Databricks
Projektart:
Migration
Automatische Übersetzung
Arbeitest du mit On-Premise SQL Server oder Azure SQL?
Beides. Für On-Premise teile ich dir einen Schema-Export und Beispielzeilen mit. Für Azure SQL kann ich direkt verbinden. Gib bei der Nachricht deine Version an (SQL Server 2016, 2019, 2022 oder Azure SQL).
Brauche ich schon einen Microsoft Fabric-Arbeitsbereich?
Nein. Das Premium-Paket enthält Lakehouse- und Arbeitsbereich-Setup von Grund auf. Für Basic und Standard benötigst du ein Fabric-Test- oder kostenpflichtiges Arbeitsbereich. Ich kann dich beim Setup als Add-on unterstützen.
Was bedeutet ein watermark-basiertes inkrementelles Pipeline?
Nach dem initialen Voll-Load verwendet die Pipeline einen Zeitstempel oder eine auto-inkrementierende Spalte, um nur neue oder geänderte Zeilen aus SQL Server zu extrahieren und in Fabric Delta-Tabellen upzudaten – kein vollständiger Reload nötig. Deine Daten bleiben ständig aktuell.
Kannst du gespeicherte Prozeduren und Ansichten migrieren?
Tabellendaten und PySpark-Pipeline-Logik sind enthalten. Eine Konvertierung gespeicherter Prozeduren zu Fabric-Notebooks oder T-SQL-Äquivalenten kann als individueller Auftrag hinzugefügt werden; kontaktiere mich zuerst mit Details.
Wie gehst du mit Tabellen mit 100M+ Zeilen um?
Ich plane mit Partitionierung, Stapel-Extraktion und inkrementeller Logik von Anfang an. Für sehr große Tabellen enthält der Migration-Plan des Basic-Pakets die empfohlene Partitionsschlüssel- und Batch-Strategie, bevor irgendein Code geschrieben wird.
Erhalte ich den Code und kann ich ihn selbst warten?
Ja. Alle PySpark-Notebooks, Pipeline-Logik und Dokumentation gehören dir. Standard- und Premium-Pakete beinhalten Inline-Code-Kommentare und eine schrittweise README, damit dein Team die Pipelines eigenständig erweitern oder warten kann.