Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden
Senior Data Engineer, der sich auf Cloud ETL und Architektur spezialisiert hat
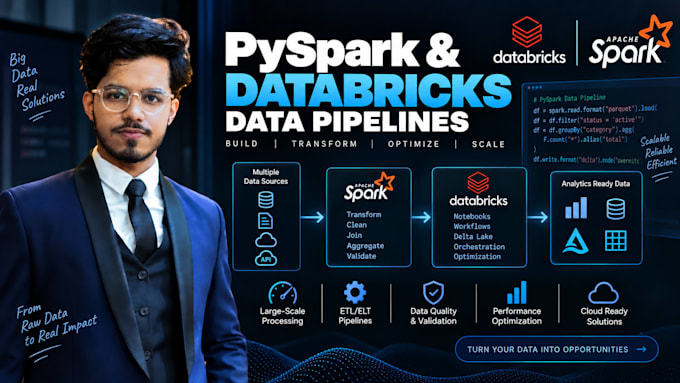
Brauchst du Hilfe bei der Verarbeitung großer Datensätze mit PySpark oder Databricks?
Ich erstelle skalierbare Datenpipelines mit PySpark, Apache Spark und Databricks für Datenumwandlung, Verarbeitung und Analyse.
Ich kann bei folgenden Aufgaben helfen:
Ich lege Wert auf saubere, wartbare und effiziente Pipelines mit klarer Dokumentation.
Kontaktiere mich vor der Bestellung bei komplexen Projekten, damit ich deine Daten und Anforderungen besser verstehe.
Warehouse-Plattform:
Snowflake
•
Azure Synapse
•
Databricks
Projektart:
New Build
Automatische Übersetzung
Arbeitest du mit Databricks?
Ja. Ich kann PySpark-Notebooks, Transformationen, ETL-Workflows und Datenverarbeitungs-Pipelines in Databricks erstellen.
Kannst du große Datensätze verarbeiten?
Ja. PySpark ist für verteilte Verarbeitung konzipiert, und ich kann Pipelines für große Datensätze bauen.
Kannst du eine bestehende Spark-Pipeline optimieren?
Ja. Ich kann langsame Jobs untersuchen und Transformationen, Joins, Partitionen und Spark-Workloads optimieren.
Kannst du inkrementelle Pipelines bauen?
Ja. Ich kann inkrementelle/batchbasierte Verarbeitung basierend auf deinen Anforderungen und verfügbaren Daten umsetzen.
Welche Datenquellen kannst du verwenden?
Ich kann mit Dateien, APIs, Datenbanken, Cloud-Speicher und Data Warehouses arbeiten, je nach Projekt.
Kannst du mit Snowflake oder anderen Warehouses arbeiten?
Ja. Ich kann Pipelines bauen, die Daten transformieren und in Plattformen wie Snowflake und andere unterstützte Warehouses laden.
Stellen Sie Unterlagen zur Verfügung?
Ja. Die Dokumentation ist entsprechend dem gewählten Paket enthalten.
Soll ich Sie vor der Bestellung kontaktieren?
Ja, vor allem bei komplexen Projekten. Bitte teile mir deine Datenquellen, erwartete Transformationen, Ziel und ungefähres Datenvolumen mit.
