Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Senior Data Engineer, der sich auf Cloud ETL und Architektur spezialisiert hat
Suchst du eine zuverlässige ETL-Pipeline, um deinen Datenworkflow zu automatisieren?
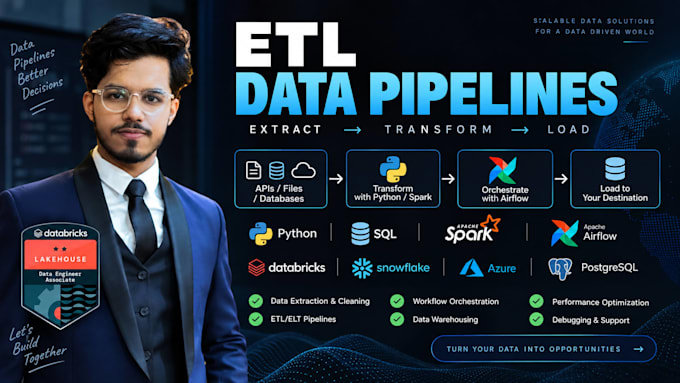
Ich erstelle eine saubere, skalierbare ETL/ELT-Pipeline mit Python, SQL, Apache Spark/PySpark und Airflow.
Ich kann dir bei folgendem helfen:
Du erhältst sauberen, wartbaren Code, passende Dokumentation und eine Lösung, die auf deine Anforderungen zugeschnitten ist.
Hast du eine bestehende Pipeline, die nicht funktioniert? Ich kann sie auch debuggen und optimieren.
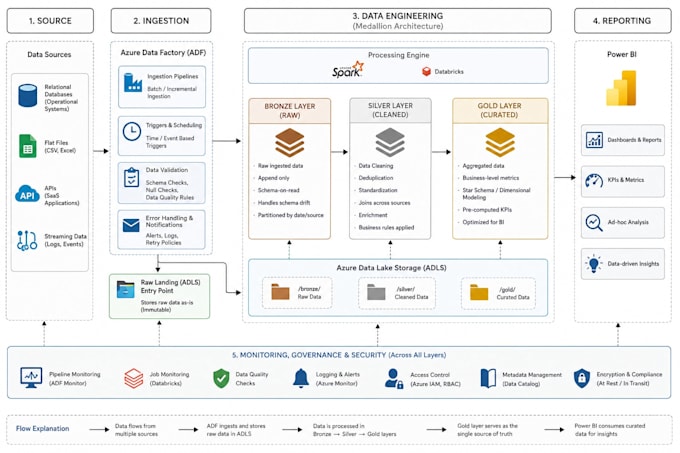
Tools und Plattformen:
Azure Data Factory
Automatische Übersetzung
Mit welchen Arten von Datenquellen können Sie arbeiten?
Ich kann mit SQL-Datenbanken, CSV/Excel-Dateien, REST-APIs, Cloud-Speicher, JSON-Daten und vielen anderen strukturierten Datenquellen arbeiten.
Kannst du Apache Airflow Workflows bauen?
Ja. Ich kann Airflow DAGs mit Planung, Abhängigkeiten, Wiederholungen, Logging und Überwachung erstellen.
Unterstützt du Apache Spark?
Ja. Ich baue Spark-Pipelines für groß angelegte Datenverarbeitung, Transformationen und ETL-Workloads.
Kannst du wiederkehrende Datenjobs automatisieren?
Absolut. Ich kann geplante Pipelines erstellen, die automatisch Daten extrahieren, transformieren, validieren und laden.
Kannst du die Pipeline deployen?
Ja. Deployment-Unterstützung mit Docker oder Cloud-Plattformen kann als Gig Extra oder im Premium-Paket enthalten sein.