Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden
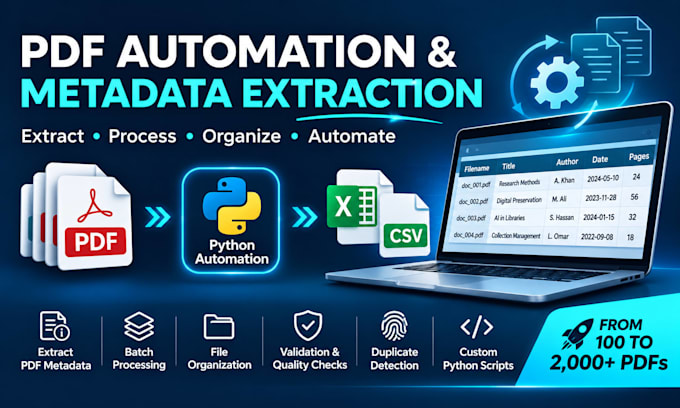
Möchtest du Hunderte oder tausende von PDF-Dateien effizient verarbeiten?
Ich entwickle Python-Automatisierungslösungen, die Unternehmen, Forschern und Privatpersonen helfen, Metadaten zu extrahieren, Dokumente zu organisieren und sich wiederholende PDF-Verarbeitungsaufgaben zu automatisieren.
Meine Dienstleistungen beinhalten:
Warum meinen Service wählen?
Ich habe hands-on-Erfahrung in der Entwicklung großer Dokumenten-Verarbeitungs- und Metadaten-Workflows. Mein Fokus liegt auf zuverlässigen, getesteten Lösungen mit klarer Dokumentation.
Was du bekommst:
Je nach Paket erhältst du strukturierte Metadatenberichte, wiederverwendbare Python-Skripte oder einen individuell angepassten PDF-Verarbeitungs-Workflow.
Bitte kontaktiere mich vor der Bestellung, um deine Anforderungen zu besprechen.
Hinweis: OCR, Texterkennung aus gescannten Dokumenten und komplexe Layouts erfordern ein individuelles Angebot.
Technologie:
Python
Expertise:
Datenextraktion
•
Datenmanipulation
Automatische Übersetzung
Kannst du hunderte oder tausende PDF-Dateien verarbeiten?
Ja! Ich kann Python-Automatisierungsworkflows entwickeln, um große Sammlungen von PDFs zu verarbeiten. Meine Pakete decken 100, 500 oder 2000 Dateien ab, je nach gewähltem Paket. Größere Sammlungen benötigen ggf. ein individuelles Angebot.
Welche Informationen kannst du aus PDF-Dateien extrahieren?
Ich kann verfügbare Metadaten wie Dokumenttitel, Autoren, Erstellungs- und Änderungsdaten, Seitenzahlen, Dateigröße und PDF-Versionen extrahieren. Der Umfang hängt von den im Dokument eingebetteten Informationen ab.
Kannst du Text aus gescannten PDFs extrahieren?
Ja, OCR-basierte Extraktion lässt sich als individueller Service besprechen. Standardpakete konzentrieren sich auf eingebettete PDF-Metadaten und beinhalten keine OCR oder Handschriftenerkennung.
In welchen Formaten erhalte ich die extrahierten Daten?
CSV ist in allen Paketen enthalten. Eine Ausgabe als Excel (.xlsx) oder JSON kann nach vorheriger Abstimmung vor der Bestellung bereitgestellt werden. Wiederverwendbare Python-Skripte sind im Standard- und Premium-Paket enthalten.
Brauchst du Zugriff auf meinen Computer oder Server?
In der Regel wird kein Fernzugriff benötigt. Ich kann die Lösung mit repräsentativen Mustern entwickeln und testen. Danach kannst du das gelieferte Skript auf deinem eigenen Windows- oder Linux-Computer ausführen.
Wie gehen Sie mit vertraulichen Dokumenten um?
Ich empfehle, anonymisierte oder nicht-sensitive Musterdateien zu verwenden. Projekte werden nur für die vereinbarte Arbeit genutzt und nicht an Dritte weitergegeben. Bespreche bitte vorher etwaige besondere Vertraulichkeits- oder Datenhandhabungsanforderungen.
Kannst du einen individuellen PDF-Verarbeitungs-Workflow erstellen?
Ja! Ich kann Workflows für Metadaten-Extraktion, Batch-Umbenennung, Duplikaterkennung, Dateivalidierung und strukturierte Berichte entwickeln. Bitte schicke mir deine Anforderungen, damit ich den Umfang einschätzen und ein passendes Angebot erstellen kann.
