Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD

Automatische Übersetzung
Beschreibung:
Ein LLM-Feature ohne Evaluationssuite zu liefern, bedeutet blind zu liefern. Ich konzipiere und baue Evaluationspipelines, die dir mit Zahlen sagen, ob deine Prompts, dein Modell oder dein RAG-Setup tatsächlich besser geworden ist – noch bevor deine Nutzer es merken.
Was du bekommst:
Bitte kontaktiere mich, bevor du einen Auftrag platzierst.
LLM AI Model Evaluation Specialist , QA automation Architect ,Eval pipelines
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Muss ich meine Produktionsdaten teilen?
Nein. Ich arbeite mit Mustern, die du auswählst, mit synthetischen Daten oder einem redigierten Export. Alles bleibt unter deiner NDA und wird bei Lieferung gelöscht.
Welche Evaluierungstools verwendest du?
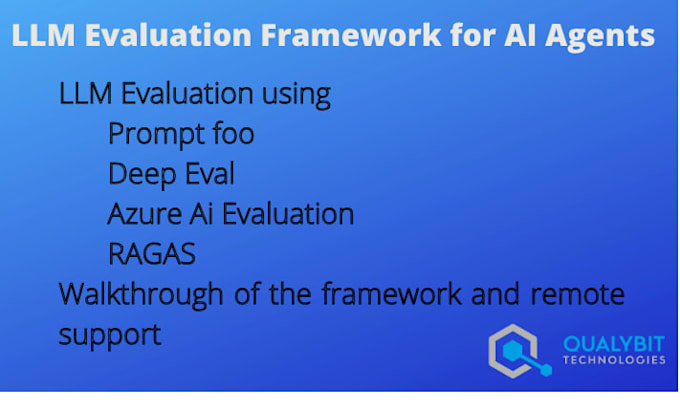
Welche Eval-Tools verwendest du? Promptfoo, LangSmith, Ragas, DeepEval oder ein einfaches Python/pytest-Harness. Ich wähle, was zu deinem Stack passt; der Code gehört dir in jedem Fall.
Kannst du ein RAG-System oder einen Agenten bewerten, nicht nur einen einzelnen Prompt?
Ja. Bei RAG bewerte ich Abruf und Generierung getrennt ( Kontextpräzision/Rückruf, Zuverlässigkeit, Relevanz der Antworten). Bei Agenten bewerte ich Korrektheit von Tool-Aufrufen und Aufgabenerfüllung.
Was bedeutet „LLM-as-judge“ und ist das zuverlässig?
Ein zweites Modell bewertet Ausgaben nach einem von dir erstellten Rubrum. Ich kalibriere es an einer von Menschen gelabelten Stichprobe, damit du weißt, wie viel du den Scores trauen kannst.
Machst du auch Red-Teaming oder Modellvergleiche?
Ja — beide Gigs sind separat in meinem Profil oder du fügst sie hier als Extras hinzu.