Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Skalierbare SaaS- und Web-Apps, Senior MERN-, Rails- und DevOps-Ingenieur
Funktionieren deine API-Integrationen nicht, ETL-Jobs überspringen Datensätze oder Dashboards zeigen unvollständige Daten?
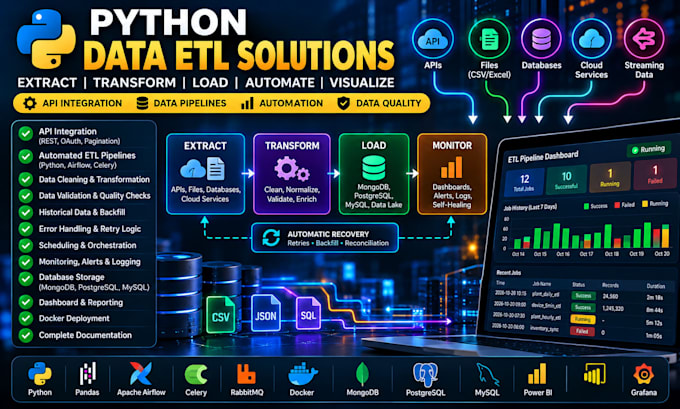
Ich baue und repariere zuverlässige Python ETL/ELT-Pipelines, die Daten aus REST-APIs, Datenbanken, CSV/Excel und Cloud-Speichern in saubere, nutzbare Datensätze verschieben.
Was ich liefern kann:
API-Integration, Pagination, OAuth und Ratenlimit-Verarbeitung
Automatisiertes ETL/ELT mit Python, SQL, Pandas oder Polars
Inkrementelles Synchronisieren, Checkpoints, Deduplication und sichere Upserts
Datenvalidierung, Qualitätsprüfungen und Datenabgleich
Historische Daten-Backfill, Retries und Fehlerbehebungen
Planung und Aufgabenschlangen mit Cron, Celery/RabbitMQ oder Airflow
Strukturierte Logs, Fehlerbenachrichtigungen und Dashboards zur Pipeline-Überwachung
PostgreSQL, MySQL, MongoDB, BigQuery oder Snowflake-Integration
Docker-Bereitstellung, Pytest-Tests und klare Dokumentation
Ideal für SaaS, E-Commerce, IoT, Finanzen und Reporting-Pipelines.
Ich konzentriere mich auf wiederherstellbare, beobachtbare Workflows, nicht auf Einzelskripte. Backfill hängt von Source-API-Historie und Zugriffslimits ab.
Schreib mir mit deiner Quelle, Ziel und dem aktuellen Problem, bevor du bestellst.


Tools und Plattformen:
Kafka Connect
•
Andere
Automatische Übersetzung
Kannst du eine bestehende ETL-Pipeline reparieren?
Ja. Ich kann bestehende Python-ETL-Skripte prüfen, fehlgeschlagene API-Anfragen untersuchen, Datenverarbeitungsfehler identifizieren, Datenbank-Operationen verbessern und passende Retry- sowie Wiederherstellungsmechanismen implementieren.
Kannst du fehlende historische Daten wiederherstellen?
Ja, sofern die Quelle API oder Datenbank historische Datensätze bereitstellt. Ich kann automatisierte Backfill-Workflows implementieren, die fehlende Perioden identifizieren, verfügbare Datensätze abrufen und deine Datenbank sicher aktualisieren.
Stellst du automatische Retries und Wiederherstellung sicher?
Ja. Je nach Anforderungen implementiere ich Retry-Logik, exponentiellen Backoff, persistente Job-Verfolgung, Recovery-Queues und Aufgaben-Ausführung mit Celery und RabbitMQ.
Welche Datenbanken unterstützen Sie?
Ich kann mit Datenbanken wie PostgreSQL, MongoDB und MySQL arbeiten. Cloud-Lager-Integrationen, einschließlich BigQuery und Snowflake, können je nach Projektanforderungen besprochen werden.
Kann ich meine Daten-Pipelines überwachen?
Ja. Ich implementiere Ausführungsprotokolle, Job-Status-Tracking, Fehlerbenachrichtigungen, tägliche Gesundheitsberichte und benutzerdefinierte Überwachungsoberflächen mit Python-basierten Backend-Technologien.
Kannst du garantieren, dass nie Daten verloren gehen?
Kein System kann die Verfügbarkeit von Daten bei externen Anbietern garantieren. Allerdings implementiere ich zuverlässige Ausführungs-Verfolgung, Validierung, Retries, Abgleich und Wiederherstellungsmechanismen, um vermeidbaren Datenverlust zu reduzieren und ungelöste Lücken zu erkennen.