Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD


Automatische Übersetzung
Deine KI-App funktioniert im Demo, aber bei echten Nutzern gibt es Probleme: falsche Antworten, Halluzinationen, langsame Reaktionen, überraschende API-Rechnungen. Ich finde heraus, warum das so ist, und behebe es.
Häufige Lösungen:
Funktioniert mit LangChain, LlamaIndex, rohen OpenAI/Claude SDKs, Vercel AI SDK, AWS Bedrock und n8n.
Warum ich: Als Engineering Manager, der KI-Initiativen leitet, habe ich Produktions-RAG-Pipelines und KI-Review-Agenten umgesetzt. Mir sind die unscheinbaren Dinge wichtig: Evals, Fehlerfälle und Kosten pro Anfrage.
Schick mir eine Nachricht mit deinem Stack und 3-5 Beispielen schlechter Ausgaben.
Engineering Manager building production RAG and AI agents
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Benötigen Sie Zugriff auf meinen Code?
Der beste Zugang ist Lesezugriff auf das Repo. Für das Audit-Paket funktionieren auch Code-Snippets plus eine Bildschirmfreigabe.
Wirst du alles neu schreiben?
Nein. Ich mache die kleinste Änderung, die das Problem behebt, und erkläre warum.
Wie weiß ich, ob es wirklich besser geworden ist?
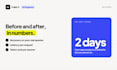
Standard- und Premium-Pakete enthalten Vorher-Nachher-Zahlen auf einem Testset: Genauigkeit, Latenz und Kosten pro Anfrage.


