Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
AWS Data Engineer, ETL, PySpark, AWS Glue, Airflow
Nutze den vollen 1200-Zeichen-Raum, um das Gig schlüsselwortreich, aber dennoch lesbar zu gestalten:
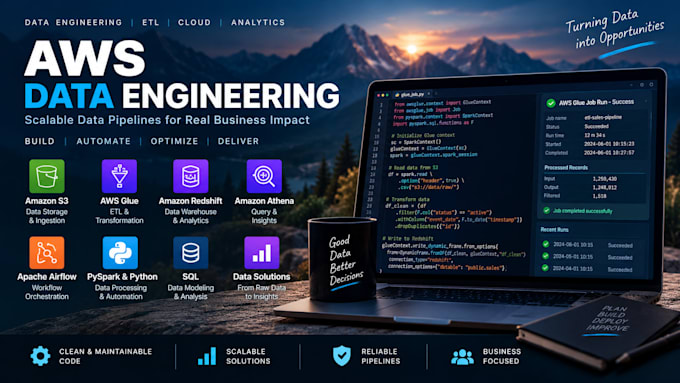
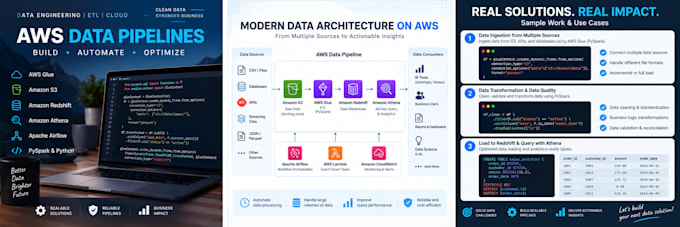
Ich baue zuverlässige und skalierbare AWS ETL-Datenpipelines mit AWS Glue, PySpark, Python, Amazon S3, Amazon Redshift und anderen AWS-Diensten.
Ich kann dir helfen, neue Datenpipelines zu entwickeln, Datenverarbeitung zu automatisieren, Datensätze zu transformieren oder bestehende ETL-Workflows zu beheben.
Meine Dienstleistungen umfassen:
Entwicklung von AWS Glue ETL-Jobs
PySpark- und Python-Datenumwandlungen
S3-Datenaufnahme und -verarbeitung
Verarbeitung von CSV-, JSON- und Parquet-Daten
Redshift-Datenladen und -transformation
Athena- und Apache Iceberg-Lösungen
Datenvalidierung und -abgleich
Fehlerbehandlung und Pipeline-Logging
Optimierung der ETL-Leistung
Datenmigration und Automatisierung
Ich konzentriere mich auf saubere, wartbare und produktionsbereite Lösungen mit ordnungsgemäßer Validierung, Fehlerbehandlung und Dokumentation.
Egal, ob du eine kleine ETL-Aufgabe oder eine komplette AWS-Datenpipeline benötigst, ich kann eine Lösung basierend auf deinen Anforderungen entwickeln.
Bitte kontaktiere mich vor der Bestellung bei komplexen oder Multi-Service-Anforderungen, damit ich deinen Umfang verstehe und das passende Paket empfehlen kann.
Technologie:
Amazon Redshift
•
Excel
•
Python
•
SQL
•
NoSQL
•
Apache Airflow