Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD

Automatische Übersetzung
Deine Dokumente enthalten bereits die Antworten. Ich entwickle den AI-Assistenten, der sie findet.
Ich entwerfe maßgeschneiderte Retrieval-Augmented Generation (RAG) Apps, mit denen du Fragen in einfachem Englisch stellen und Antworten erhalten kannst, die in deinen eigenen Dateien verankert sind, inklusive des genauen Quellenzitats hinter jeder Antwort.
Im Gegensatz zu generischen Chatbots, die Fakten selbstsicher erfinden, sind meine Builds gegen Halluzinationen ausgelegt: Jede Antwort wird aus deinen Dokumenten abgerufen, anhand eines strengen Schemas validiert und das unterstützende Zitat wird programmatisch mit dem Quelltext überprüft. Nicht verifizierbare Behauptungen werden markiert, nicht gefälscht.
Was ich baue
Q&A-Chatbots für PDFs, Berichte, Transkripte, Verträge oder eine Wissensdatenbank
Strukturierte Extraktion definierter Felder aus jedem Dokument
Querverweisende Synthese von gemeinsamen Themen und Meinungsverschiedenheiten
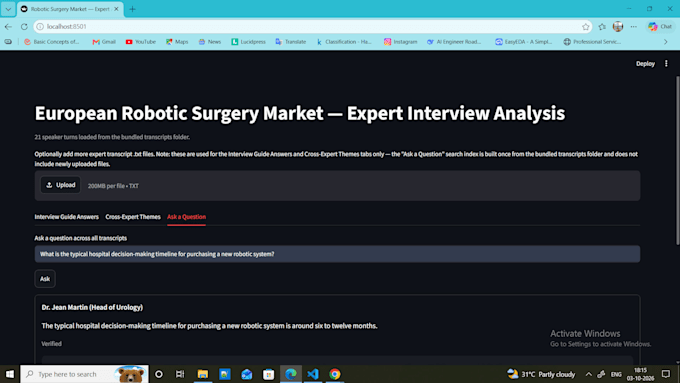
Eine saubere Streamlit-Oberfläche, die dein Team tatsächlich nutzen kann
Technologie-Stack
LangChain, Hugging Face & OpenAI-Modelle, FAISS Vektorsuche, sentence-transformer Einbettungen, Pydantic strukturierte Ausgaben, Streamlit, Python.
Referenz-Build
Sieh dir das Portfolio-Item an, einen Analyse-Tool für Experteninterviews, das verifizierte Zitate mit Zeitstempeln aus Markt-Research-Transkripten liefert.
Schreib mir mit deinen Dokumenten und den Fragen, die du beantwortet haben möchtest
AI Engineer, LLMs, RAG, MultiAgents Systems, Python, LangGraph, LangChain
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Mit welchen Dokumenten kannst du arbeiten?
PDFs, Word-Dateien, Klartext, Transkripte, CSV und gescrapte Webseiten. Wenn du eine Probe schicken kannst, bestätige ich, dass sie sauber geparst wird, bevor du bestellst.
Wie stellst du die Genauigkeit der Antworten sicher?
Jede Antwort wird ausschließlich aus deinen Dokumenten generiert (retrieval-gestützt, nicht aus dem Speicher des Modells), ist an ein strenges Datenschema gebunden und das unterstützende Zitat wird vor der Anzeige mit dem Quelltext überprüft. Wenn es nicht verifiziert werden kann, wird es markiert, anstatt als Fakt präsentiert.
Welches KI-Modell verwendest du?
Das hängt von deinen Bedürfnissen ab. Ich nutze häufig Meta Llama 3.1 via Hugging Face und kann auch OpenAI oder ein offenes lokales Modell verwenden, falls du niedrigere Kosten oder vollständige Privatsphäre möchtest. Wir entscheiden gemeinsam beim ersten Kontakt.
Bekomme ich den Quellcode?
Ja — jedes Paket enthält den vollständigen, dokumentierten Quellcode und eine Installationsanleitung. Kein Lock-in.
Kann es privat auf meinen eigenen Daten laufen?
Ja. Für sensible Daten können wir ein selbstgehostetes offenes Modell laufen lassen, sodass nichts dein Umfeld verlässt.
Können Sie es für mich bereitstellen?
Ja, als Premium-Feature oder Gig-Extra. Du erhältst einen funktionierenden Link und die Hosting-Konfiguration.
Wie viel Daten kann es verarbeiten?
Es skaliert von wenigen Dateien bis zu Tausenden von Dokumenten. Über ein kleines Korpus hinaus speichere ich den Vektorindex auf der Festplatte, damit er nicht bei jedem Lauf neu aufgebaut wird.
Was brauchst du von mir, um anzufangen?
Deine Dokumente (oder eine repräsentative Stichprobe), 3–5 Beispiel-Fragen, die du beantwortet haben möchtest, sowie Branding- oder Interface-Präferenzen.
