Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Senior SRE und Backend-Architekturberater
Hör auf, im Dunkeln zu tappen, wenn dein Backend ausfällt.
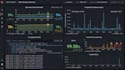
In modernen Microservices ist es oft schwieriger zu wissen warum ein System abgestürzt ist, als es zu beheben. Sichtbarkeit ist die Grundlage des Site Reliability Engineering (SRE). Ich spezialisiere mich darauf, unternehmenstaugliche Observability-Stacks zu entwickeln, die chaotische Logs in umsetzbare Metriken verwandeln.
Als Senior Backend-Architekt installiere ich nicht nur Tools, sondern baue widerstandsfähige Monitoring-Architekturen.
Was dieses SRE Gig abdeckt:
Dies ist ein Premium-L3-Infrastrukturservice, kein einfacher IT-Support. Arbeite mit mir zusammen, um echte SRE-Kultur in dein Backend zu bringen.
️ Spezial-Einführungspreis: Bitte beachte, dass diese aktuellen Preise ausschließlich für meine
Automatische Übersetzung
Welche Art von Zugriff benötigst du, um die Einrichtung abzuschließen?
Ich benötige SSH-Zugriff auf deine Zielserver oder dein Cluster. Für Cloud-Umgebungen (wie AWS, GCP) ist ein IAM-Benutzer mit eingeschränkten Berechtigungen aus Sicherheitsgründen vorzuziehen. Bei strengen Compliance-Richtlinien können wir die Bereitstellung auch über eine geführte Screen-Share-Sitzung durchführen.
Verlangsamen diese Monitoring-Agenten meine Server?
Überhaupt nicht. Ich verwende hochoptimierte, leichte Agenten (wie Promtail), die speziell für Unternehmen-Microservices entwickelt wurden. Sie laufen mit minimalem CPU- und Speicherverbrauch, sodass die Leistung deiner Anwendung unberührt bleibt.
Kannst du benutzerdefinierte Anwendung-Logs und Datenbankabfragen überwachen, oder nur die grundlegende Servergesundheit?
Beides. Während grundlegende Setups die Infrastruktur (CPU, RAM) abdecken, tauchen meine erweiterten Pakete tief in benutzerdefinierte Backend-Logs, API-Timeouts und schwere Datenbankabfragen (PostgreSQL/MongoDB) mit fortgeschrittenem LogQL ein.
Ich habe eine hochkomplexe, Multi-Cluster-Architektur. Wie sollen wir vorgehen?
Bitte sende mir eine Nachricht, bevor du eine Bestellung aufgibst. Komplexe Unternehmensarchitekturen erfordern einen maßgeschneiderten Ansatz. Wir besprechen zuerst deine Engpässe, und ich erstelle eine individuelle technische Roadmap sowie ein spezielles Angebot.


