Kategorien durchsuchen
Deutsch
$
USD
Verbinden Sie sich mit Ihrer KI
Python- und Data Engineer Web Scraping ETL-Pipelines SQL KI-Video-Generator
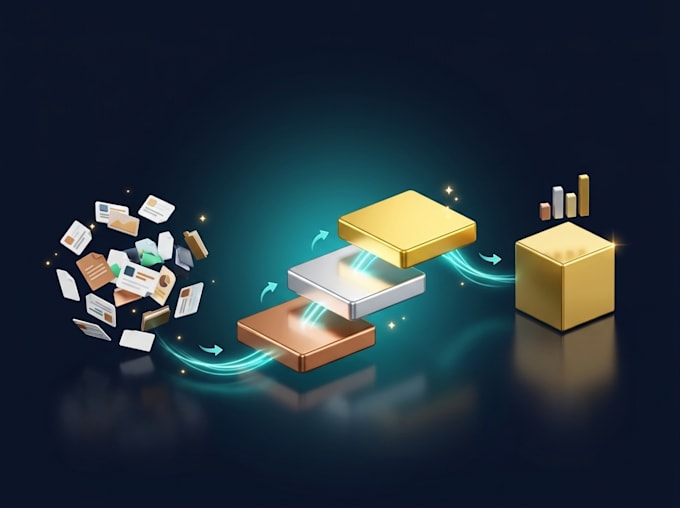
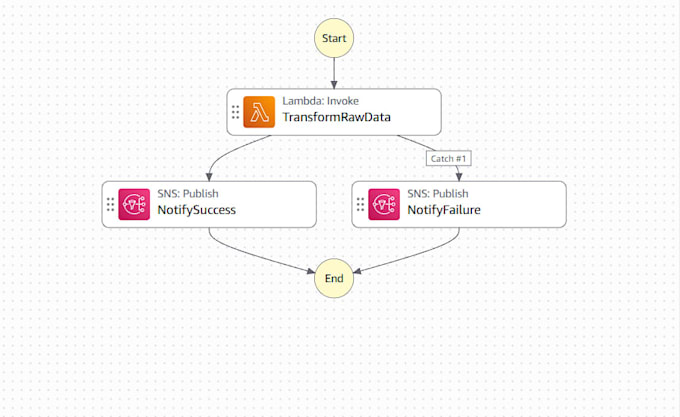
Hast du rohdaten in CSV-Dateien, APIs oder unübersichtlichen Tabellen? Ich wandel sie in saubere, analysefertige Tabellen um – mit Databricks, PySpark und Delta Lake under der Medallion-Architektur (Bronze, Silver, Gold).
Was du bekommst:
Bronze-Ebene: Rohdaten sicher aufgenommen, nichts geht verloren
Silver-Ebene: bereinigte, duplizierte Daten entfernt und standardisiert
Gold-Ebene: geschäftsbereite Tabellen für Berichte und Dashboards
Gut kommentierte PySpark- und SQL-Notebooks
Datenqualitätsprüfungen (Nullwerte, Duplikate, falsche Formate)
Einfache Dokumentation, damit dein Team sie pflegen kann
Mein Beleg: Ich habe ein End-to-End-Databricks-Projekt aufgebaut, das über 51.000 Datensätze durch alle drei Medallion-Ebenen verarbeitet hat. Ich bin ein micro1 Certified Data Engineer mit Cloud Data Engineer Training (Python, SQL, AWS, Snowflake, Spark).
Hinweis: Die Pipeline läuft in deinem Databricks-Arbeitsbereich, du besitzt deine Daten. Ein kostenloses Databricks-Konto reicht für kleine Projekte aus.
Sende mir vor der Bestellung eine Nachricht mit deiner Datenquelle und deinem Ziel, dann empfehle ich das passende Paket.

Automatische Übersetzung
Brauche ich ein kostenpflichtiges Databricks-Konto?
Nein. Ein kostenloses Konto reicht für kleine Projekte. Größere Workloads benötigen eventuell einen kostenpflichtigen Workspace in deinem Namen.
Kannst du meine bestehenden Notebooks verbessern?
Ja. Schick mir die Details und ich erstelle dir ein individuelles Angebot.
Werde ich verstehen, wie es funktioniert?
Ja. Notebooks sind kommentiert, und Premium enthält eine Durchsicht.