Ich werde Azure Databricks Data Engineer, PySpark, SQL, ETL, DBT ausführen

Einige Informationen wurden automatisch übersetzt.

Indien

Ich spreche Englisch

Azure Databricks, Data Engineer, PySpark, Azure, SQL, ETL, Oracle

Data Engineer mit über 3 Jahren IT-Erfahrung in der Unterstützung von Unternehmensanwendungen und Datenbanken, spezialisiert auf Oracle SQL/PLSQL, Datenverarbeitung, ETL und Datenbankoperationen. Prak...
Über diesen Service
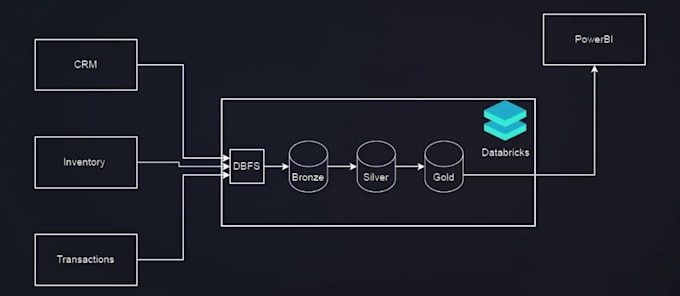
  • Ich baue und pflege ETL/ELT-Datenpipelines mit Databricks, PySpark, Python und SQL.
  • Arbeiten mit Azure- und AWS-Cloud-Plattformen, hauptsächlich mit ADLS Gen2 und Amazon S3 für die Datenspeicherung.
  • Entwickle Databricks-Notebooks, um Daten zu extrahieren, transformieren, bereinigen und laden aus verschiedenen Quellen.
  • Verwende PySpark, um große Datensätze zu verarbeiten und Joins, Aggregationen, Filterung und Transformationen durchzuführen.
  • Arbeite mit Delta Lake, um zuverlässige und skalierbare Datentabellen zu erstellen.
  • Entwerfe Bronze-, Silver- und Gold-Schichten, um Daten effizient zu organisieren und zu verarbeiten.
  • Verbinde Databricks mit Datenbanken wie Oracle, SQL Server, MySQL und PostgreSQL.
  • Erstelle SQL-Abfragen für Datenextraktion, -transformation, -validierung und -analyse.
  • Baue sowohl Batch- als auch inkrementelle Datenpipelines, je nach Geschäftsanforderung.
  • Plane und automatisiere Pipelines mit Databricks Workflows und Jobs.
  • Verwende Azure Data Factory für Pipeline-Orchestrierung und Integration mit Azure-Diensten.
  • Führe Datenqualitätsprüfungen durch, inklusive Umgang mit Null-Werten, Duplikaten, falschen Daten und Schemaänderungen.
  • Behebe fehlgeschlagene Pipelines und untersuche Daten- und Spark-Job-Probleme.
  • Optimiere PySpark-Jobs mit Techniken wie Partitionierung, Caching.

Warehouse-Plattform:

redshift

•

Fabric Warehouse

•

Databricks

Projektart:

New Build