Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden
Web Scraping und Produktdaten nach Excel oder CSV
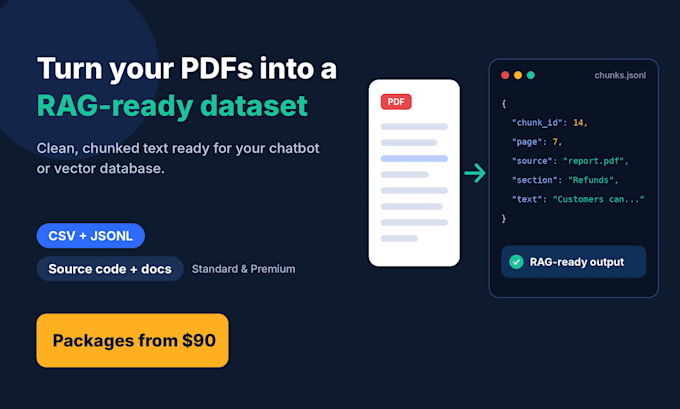
Du willst deine PDFs in ein sauberes, Rag-ready Dataset verwandeln? Ich erstelle strukturierte Daten, die du direkt in deine Rag-Pipeline, Chatbot oder Wissensdatenbank pluggen kannst.
Was du bekommst:
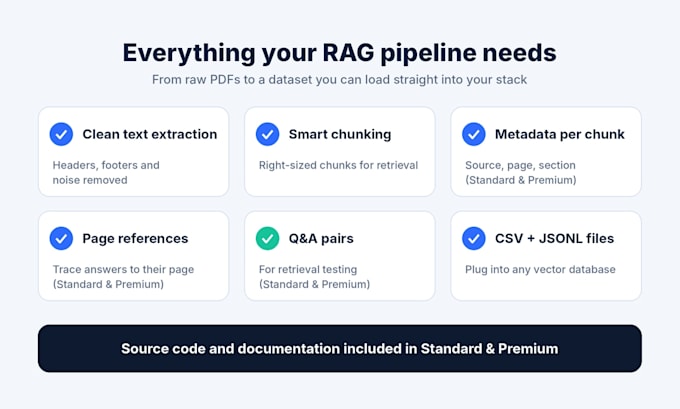
️ Präzise Texterkennung (Kopf- und Fußzeilen sowie Störgeräusche bereinigt)
️ Intelligente Segmentierung mit Seitenverweisen
️ Metadaten für jedes Segment (Quelle, Seite, Abschnitt)
️ Fertig vorgefertigte Q&A-Paare zum Retrieval-Tests und zur Bewertung von LLMs (Standard & Premium)
️ JSONL-Datensatz + CSV, bereit für deine Rag-Pipeline und Vektor-Datenbank
️ Quellcode und Dokumentation (Standard & Premium)
So arbeite ich: Ich überprüfe Outputs mit mehreren Modellen und verifiziere Stichproben manuell gegen deinen Originaltext, um Halluzinationen zu reduzieren. Deine Dateien behandle ich vertraulich.
Perfekt geeignet für: AI-Startups, Chatbot-Entwickler, Forscher und Entwickler, die eine Wissensbasis oder Rag-Pipeline aufbauen.
Starte mit Basic, um eine PDF zu testen, und skaliere dann. Schreibe mir vor derORDER mit deinem PDF-Typ und Seitenzahl!

Expertise:
Andere
Frameworks:
Panda
Datentyp:
Text
Programmiersprache:
Python
•
SQL
Tools:
Excel
•
Colab
APIs:
OpenAI
Automatische Übersetzung
Welche Dateien akzeptierst du?
Nur PDFs. Wenn deine Datei Word, PPT oder ein Bild ist, schreib mir zuerst, damit ich bestätigen kann, ob sie konvertiert werden kann.
Arbeitest du mit gescannten PDFs?
Textbasierte PDFs funktionieren am besten. Gescannte PDFs benötigen OCR und brauchen eventuell mehr Zeit oder ein individuelles Angebot, also schick bitte vor der Bestellung eine Musterseite.
Was bekomme ich?
Jedes Paket liefert dir ein sauberes CSV + JSONL-Datensatz mit segmentiertem Text. Standard & Premium enthalten außerdem Metadaten, Seitenverweise, Q&A-Paare, Quellcode und Dokumentation.
Sind meine Dateien vertraulich?
Ja. Ich teile deine Dateien nicht und verwende sie nicht erneut. Falls deine Dokumente sensibel sind, sag mir vor der Bestellung Bescheid, damit ich klären kann, wie sie behandelt werden.
Wie viele Seiten sind im Paket enthalten?
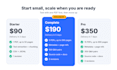
Basis: 1 PDF bis 50 Seiten. Standard: 5 PDFs bis 200 Seiten. Premium: 15 PDFs bis 600 Seiten. Für mehr sprich mich bitte für ein individuelles Angebot an.
Kann ich zuerst mit einer PDF testen?
Ja, genau dafür ist Basic da. Teste eine PDF, prüfe die Qualität und skaliere dann auf Standard oder Premium.