Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD



Automatische Übersetzung
Verlorene Stunden beim Abtippen von Rechnungen, Quittungen, Formularen und gescannten Verträgen? Genau das entfernt diese Pipeline.
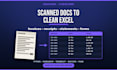
MS Data Science, IBM Data Science Professional. Ich erstelle Dokumenten-AI-Extraktionspipelines in Python mit einem Multi-Engine OCR-Ensemble – PaddleOCR, Tesseract und EasyOCR, die sich gegenseitig überprüfen – und wandeln Scans und PDFs in saubere Excel-, CSV-, JSON- oder Datenbankeinträge um.
Datenschutz ist integriert: alles läuft auf deinem eigenen Server oder einem Offline-Rechner – keine OCR-Clouds von Drittanbietern, ich speichere keine Kopien, NDA auf Wunsch.
Was du bekommst:
- Multi-Engine OCR-Ensemble, abgestimmt auf deinen Dokumententyp
- Strukturierte Ausgabe: Excel, CSV, JSON oder direkte Datenbankübertragung
- Feldgenaue Extraktion – Rechnungsnummern, Summen, Daten, IDs, Namen, Positionen
- Datenschutzorientierte Bereitstellung auf deiner eigenen Infrastruktur
- Dokumentation + eine aufgezeichnete Setup-Anleitung
Beweis: Ein datenschutzorientiertes OCR-System, das ich gebaut habe (PaddleOCR + Tesseract + EasyOCR + FAISS), hat über 300 Dokumente vollständig offline verarbeitet.
Stack: Python, PaddleOCR, Tesseract, EasyOCR, Claude Code.
Gib deine Bestellung auf – füge eine Beispieldatei im Anforderungsformular bei, und ich bestätige den Umfang. Möchtest du vorher eine Überprüfung? Schick mir eine geschwärzte Probe.
AI Agent Chatbot and App Developer MS Data Science IBM Certified
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Welche Dokumente kann er verarbeiten?
Rechnungen, Quittungen, Formulare, Ausweise, Verträge, Kontoauszüge, gescannte Archive – gedruckt oder handgeschrieben, sofern die Scanqualität es zulässt. Schick ein Beispiel, und ich bestätige, was extrahierbar ist.
Wie genau ist OCR wirklich?
Ein einzelner Engine erreicht etwa 90–95 % bei sauberen Scans; das Multi-Engine-Ensemble erhöht das bei verrauschten Dokumenten durch Überprüfung. Ich kalibriere zuerst an deinen echten Beispielen und markiere Felder mit niedriger Zuverlässigkeit, anstatt still zu raten – und wenn die Scanqualität das Limit ist, sage ich dir das vorher.
Werden meine Dokumente an einen Drittanbieter weitergegeben?
Nein – die Pipeline läuft lokal auf deinem Rechner, Server oder in einem Docker-Container, den du kontrollierst. Nichts verlässt deine Umgebung, außer du wünschst eine Cloud-Deployment. NDA auf Wunsch erhältlich.
Kann es Tabellen und Positionen verarbeiten?
Ja – Tabellen- und Positionsextraktion ab Standard, geliefert als strukturierte Zeilen mit Feldzuordnung.
Funktioniert es mit meinem Dokumentenmanagement- oder Buchhaltungssystem?
Ja – die Ausgabe landet dort, wo du arbeitest: Excel/CSV für Buchhaltungstools wie QuickBooks oder Xero, JSON für Entwickler oder direkte PostgreSQL/SQL-Schreibvorgänge. Es kann einen Ordner als Input überwachen, und die Premium API ermöglicht es jedem System, Extraktionen automatisch abzurufen. Teile deine Einrichtung mit mir, und ich bestätige den Weg.
Nicht-englische Dokumente?
PaddleOCR unterstützt über 80 Sprachen; nicht-englische Layouts benötigen eventuell eine kurze Feinabstimmung (als Add-on pro Sprache erhältlich).
Laufende Unterstützung?
Ja – ein monatlicher Care Plan (~269$) deckt neue Dokumententypen, Genauigkeitstuning und eine festgelegte Anzahl an Supportstunden ab.
Du hast noch keine Bewertungen – warum solltest du vertraut werden bei sensiblen Dokumenten?
Gute Frage – und genau deshalb läuft diese Pipeline komplett auf deinem eigenen System. Zugangsdaten sind öffentlich verifizierbar (MS Data Science; IBM Data Science Professional); die Basic-Stufe ist ein risikoarmer Pilot für einen einzelnen Dokumenttyp; Fivers Resolution Center schützt deine Bestellung.
Antwortgeschwindigkeit, Datenresidenz und Eigentum?
Ich antworte innerhalb weniger Stunden (überlappend mit UK/EU-Morgen und US-Ost-Nachmittag, asynchron via Fiverr). GDPR-konform von Grund auf – Dokumente verlassen niemals deine Umgebung; auf Wunsch schriftliche Datenverarbeitungsnotiz; du besitzt den gesamten Code und die Ergebnisse bei Lieferung; NDA auf Wunsch.
Kann ich die extrahierten Dokumente später durchsuchen oder mit ihnen chatten?
Ja – sobald sie strukturiert und indexiert sind, ermöglicht dir mein AI-Chatbot-Gig, Fragen in einfachem Englisch zu stellen.