Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD

Automatische Übersetzung
Die meisten Datenprobleme sind keine Analyseprobleme. Es sind Bereinigungsprobleme, die niemand anschauen möchte.
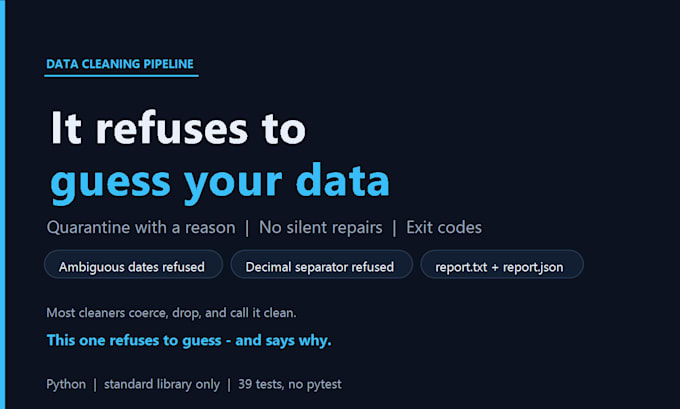
Eine Pipeline, die still und heimlich schlechte Daten "repariert", ist schlimmer als eine, die sie ablehnt. Sie verwandelt 15/01/2026 in den falschen Monat, löscht 3 % der Zeilen und erstellt einen Bericht, der sauber aussieht, aber falsch ist.
WAS DU BEKOMMST
- Eine Python-Pipeline, die deine Dateien liest, das bereinigt, was sie beweisen kann, und den Rest mit einem schriftlichen Grund in Quarantäne steckt.
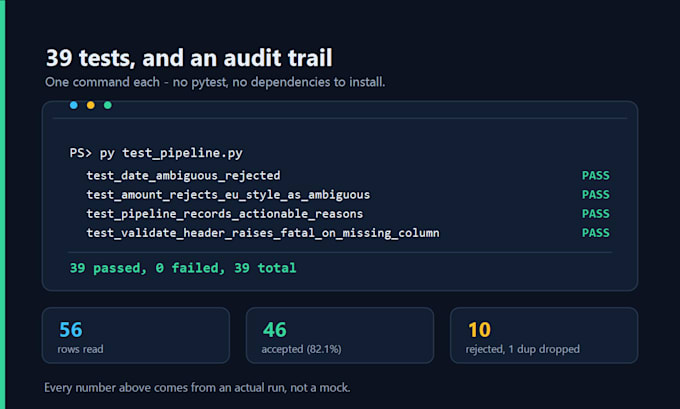
- Jede abgelehnte Zeile landet in einer eigenen Datei mit Quelle und Zeilennummer. Nichts wird stillschweigend gelöscht.
- Validierungsregeln, die du lesen und ändern kannst: Typen, Bereiche, Pflichtfelder, Datumsformate, Duplikate.
- Ein prüfbarer Bericht plus Exit-Codes, damit es laut scheitert, anstatt eine falsche Datei zu schreiben.
- Tests, damit du die Regeln ändern kannst, ohne sie zu brechen.
- Ein Übergabedokument: Was wurde gebaut, wie man es ausführt, was überprüft wurde und die Grenzen.
WIE ICH ARBEITE
Ich schaue mir deine Daten an, bevor ich ein Angebot mache. Wenn eine Spalte unklar ist, frage ich lieber nach, anstatt zu raten.
STACK
Python, nur Standardbibliothek. Nichts zu installieren.
Sag mir, was "sauber" für deine Daten bedeutet, und ich sage dir, ob es passt. Muster auf GitHub – Nachricht für den Link.
all
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Welche Dateiformate kannst du bearbeiten?
Standardmäßig CSV. Excel, TSV und Fixed-Width-Text sind ebenfalls in Ordnung. Deine Quelldatei wird nie verändert – die Pipeline liest sie ein und schreibt neue Dateien.
Was passiert mit Zeilen, die du nicht bereinigen kannst?
Sie landen in einer separaten abgelehnten Datei mit Zeilennummer und Grund. Nichts wird stillschweigend gelöscht, und der Bericht zählt sie, damit du genau sehen kannst, was ausgeschlossen wurde.
Änderst du meine Originaldaten?
Nein. Die Pipeline liest nur deine Eingabedatei. Jede Ausgabe ist eine neue Datei, sodass du das Ergebnis immer mit der Quelle vergleichen kannst.
Kann es nach einem Zeitplan laufen?
Ja. Bei einem fatalen Problem beendet sie mit einem Nicht-Null-Code, sodass Cron oder Task Scheduler Erfolg oder Misserfolg erkennen, ohne dass jemand das Log lesen muss.
Meine Spalten bedeuten etwas Spezifisches für mein Geschäft.
Genau deshalb frage ich vor dem Angebot. Schick mir ein Muster, und die Validierungsregeln werden in deine Definitionen geschrieben, anstatt nur aus den Spaltennamen zu raten.