Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Dateningenieur
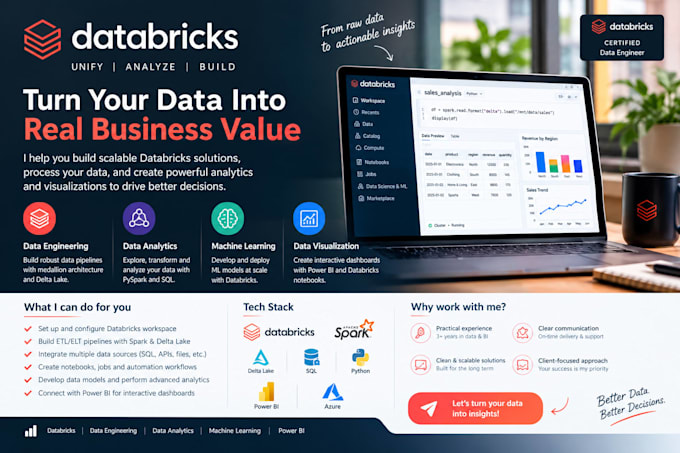
Verwandle deine Rohdaten in zuverlässige Data Pipelines mit Databricks!
Brauchst du Hilfe bei Datenverarbeitung, ETL-Pipelines oder Big Data-Transformationen mit Databricks?
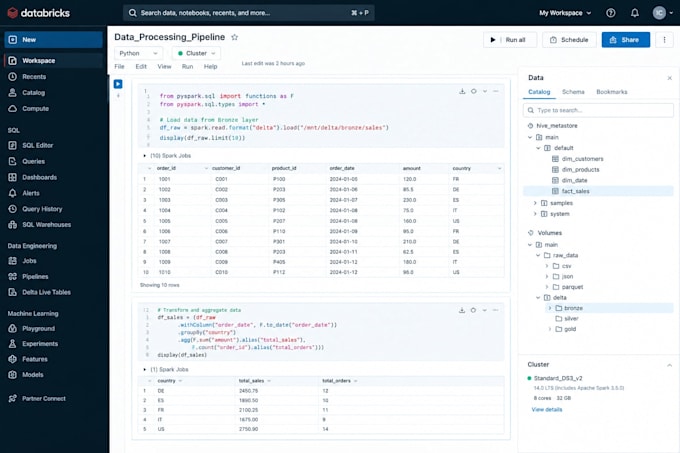
Ich kann dir beim Erstellen, Optimieren und Warten von Data Pipelines mit Databricks, PySpark, Python, SQL und Delta Lake helfen, angepasst an deine Projektanforderungen.
Mit über 3 Jahren Erfahrung in Datenanalyse, ETL-Entwicklung, Daten-Transformation und Business Intelligence weiß ich, wie man Rohdaten in strukturierte, zuverlässige und analysebereite Datensätze umwandelt.
Meine Databricks-Dienste
1. Databricks & PySpark Entwicklung
2. ETL/ELT Data Pipelines
3. Delta Lake & Lakehouse
4. SQL & Datenoptimierung
Automatische Übersetzung
Was sind deine Eingabedatenquellen und Formate?
Hast du bereits einen Databricks-Arbeitsbereich?
Was brauchen Sie zum Starten?
Bitte gib deine Projektanforderungen, Beispiel-Daten, erwartete Ergebnisse und Details zu deiner Databricks-Umgebung an.