Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden
Data-Annotation-Spezialist, Bounding Box, Polygon und Bildsegmentierung
Brauchst du ein sauberes Objekt-Erkennungs-Dataset für YOLO oder COCO?
Ich leite ein Team von über 30 Annotatoren. Großen Chargen werden auf das Team verteilt und von einem zweiten Annotator vor der Lieferung geprüft. Du hast mich als einzigen Ansprechpartner.
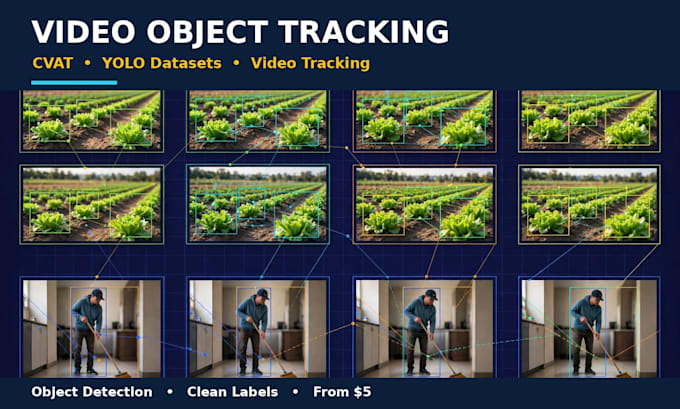
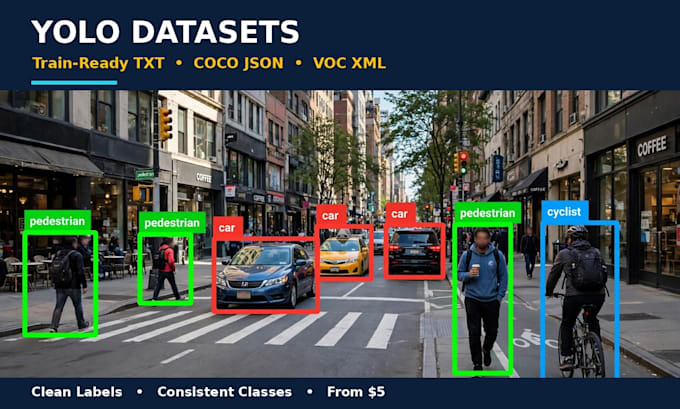
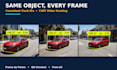
Wir erstellen YOLO- und COCO-Datasets in CVAT für Objekterkennung und Videoverfolgung. Jede Bounding Box sitzt eng, jede Verfolgung behält von Frame zu Frame dieselbe ID. Wir arbeiten an autonomen Fahrzeugen, Überwachungsvideos und Sportaufnahmen sowie an Einzelbildern.
Was wir machen:
- YOLO- und COCO-Datasets für Objekterkennung
- Video-Objektverfolgung mit konsistenten Track-IDs
- Bounding-Box-Datensätze für Bilder und Videoframes
- Polygonmasken für Segmentierungsmodelle
Was du bekommst:
- Gelabelte Frames, vor Lieferung geprüft
- YOLO TXT, COCO JSON und Pascal VOC XML Export aus CVAT
- CSV-Export und Masken-PNGs
- Zuerst eine kleine Testcharge, damit du die Qualität vor dem großen Auftrag prüfen kannst
Tools: CVAT oder deine eigene Annotierungsseite.
Formate: YOLO TXT, COCO JSON, Pascal VOC XML, CSV, Masken-PNG. Frag mich nach weiteren Formaten. Ich bestätige dir das vor deiner Bestellung.
Braucht du ein großes Dataset oder ein langes Video mit Verfolgung? Schreib mir für ein individuelles Angebot, bevor du bestellst.
Technik:
Anleitung
Tagging-Typ:
Bild
•
Video