Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
AI Engineer: LLM Agents, RAG, Document AI : Computer Vision und Video Analytics
Level 1
Hat bestimmte Leistungskriterien erfüllt und zeigt großes Potenzial auf dem Marktplatz.
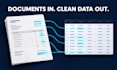
Zahlst du noch immer jemanden, der Daten von Rechnungen, Quittungen, Ausweisen oder Formularen von Hand abtippt?
Ich entwickle OCR- und Document AI-Systeme, die deine Dokumente lesen und saubere, strukturierte Daten direkt in dein Spreadsheet, deine Datenbank oder App zurückliefern.
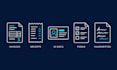
WAS ICH EXTRAHIERE
- Rechnungen und Quittungen: Positionen, Summen, Daten, Steuern, Lieferantendaten
- Ausweis- und KYC-Dokumente: Pässe, Lizenzen, Personalausweise
- Verträge und Formulare: Klauseln, Felder, Unterschriften, Kontrollkästchen
- Handschriftliche und gescannte Dokumente, inklusive schlechter Scanqualität
- Tabellen, auch wenn sie sich über mehrere Seiten erstrecken
Jede Pipeline beinhaltet Validierungsregeln, die Fehler abfangen, bevor sie dich erreichen, strukturierte JSON-, CSV- oder Excel-Ausgaben und einen Genauigkeitsbericht, damit du weißt, wie gut sie auf deinen Dokumenten funktioniert, nicht nur auf einer Demo.
STACK: Python, PaddleOCR, Tesseract, AWS Textract, Google Document AI, Azure Document Intelligence, GPT-4 Vision.
NICHT SICHER, OB ES AUF DEINE DOKUMENTE FUNKTIONIERT?
Beginne mit dem Proof of Concept. Schick 3-5 echte Dokumente und ich zeige dir die Extraktion auf DEINEN Daten, inklusive Genauigkeitsbericht, bevor du dich für eine vollständige Umsetzung entscheidest.
Sende mir 2-3 Muster und die Felder, die du brauchst, und ich sage dir ehrlich, was möglich ist.

Technologie:
Excel
•
Google Sheets
•
Python
•
Zapier
•
Andere
Automatische Übersetzung
Funktioniert das auch bei meinen speziellen Dokumenten?
Genau dafür ist das Proof of Concept Paket gedacht. Schick 3-5 deiner echten Dokumente und ich führe die Extraktion durch, zeige dir die Ergebnisse mit einem Genauigkeitsbericht, bevor du dich für etwas Größeres entscheidest. Wenn deine Dokumente nicht gut passen, erfährst du das für eine kleine Gebühr.
Welche Genauigkeit kann ich erwarten?
Es hängt von deinen Dokumenten ab, und jeder, der dir eine Zahl nennt, bevor er sie gesehen hat, rät nur. Saubere digitale PDFs mit einheitlichem Layout erreichen in der Regel sehr hohe Genauigkeit. Schlechte Scans, Handschrift und stark variierende Layouts sind schwieriger. Deshalb enthält jedes Paket einen Genauigkeitsbericht, der die Messung übernimmt.
Bekomme ich den Quellcode und eine funktionierende API?
Ja, ab dem Standard-Paket. Du bekommst den vollständigen Quellcode, und das Premium-Paket beinhaltet eine API sowie Deployment auf deinem eigenen Server, containerisiert mit Docker, inklusive Dokumentation, damit dein Team es ohne mich warten kann.
Meine Dokumente sind vertraulich. Sind meine Daten sicher?
Ja, und ich werde konkret. Ich brauche nur Muster-Dokumente, und du kannst sensible Werte vor dem Senden schwärzen. Falls deine Dokumente überhaupt nicht von einem Drittanbieter verarbeitet werden können, kann ich die ganze Pipeline mit selbstgehostetem Open-Source-OCR aufbauen, sodass nichts dein eigenes System verlässt.
Kannst du handschriftliche Texte oder Scans niedriger Qualität verarbeiten?
Oft ja, aber ehrlich gesagt variiert es mehr als bei gedrucktem Text. Handschrift, verblasste Scans, schiefe Fotos und niedrige Auflösung bei Faxen verringern die Genauigkeit, und der Umfang hängt von deinen spezifischen Dokumenten ab. Vorverarbeitung hilft enorm. Schick Muster deiner schlimmsten Dokumente im Proof of Concept, und ich zeige dir, was möglich ist.
Welches Ausgabeformat erhalte ich?
Was immer in deinen Workflow passt: strukturiertes JSON, CSV, Excel oder direkt in deine Datenbank oder App via API. Sag mir, wohin die Daten sollen, und ich liefere sie in diesem Format, anstatt dir eine Datei zum Konvertieren zu schicken.


