Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD



Automatische Übersetzung
Stehst du auf Daten, die du nicht lesen kannst? Weißt du nicht, welche Kunden du ansprechen sollst, welche bald abspringen oder was deine Zahlen treibt?
Genau das behebe ich.
Schick mir dein Datensatz und ich finde die Muster, die darin versteckt sind, und erkläre dir, was sie für dein Business bedeuten – ganz ohne Fachchinesisch.
So löse ich das
Was sich für dich ändert
Ich sage dir ehrlich, was deine Daten beantworten können und was nicht, bevor du auch nur einen Dollar investierst.
Schick mir dein Dataset und dein Ziel. Ich prüfe es und empfehle dir den besten Ansatz.
Data Scientist and Full Stack Developer
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Welche Daten benötigst du, um loszulegen?
Du kannst dein Dataset im CSV-, Excel- oder JSON-Format bereitstellen. Falls deine Daten unrein sind, kann ich auch die Vorverarbeitung übernehmen.
Welche Clustering-Algorithmen verwendest du?
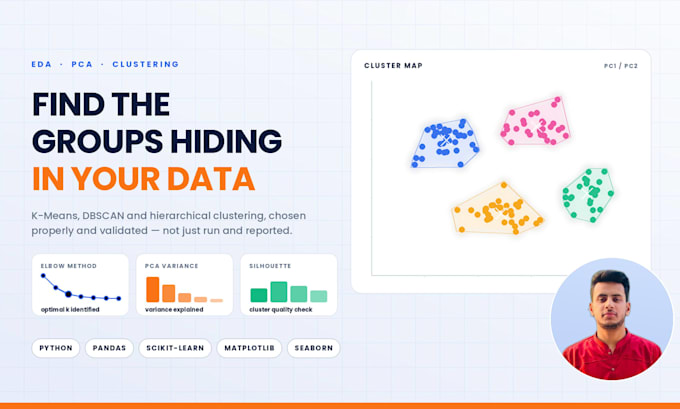
Ich nutze K-Means, hierarchisches Clustering und DBSCAN. Ich wähle die beste Methode basierend auf deinem Dataset und deinen Zielen.
Machst du Dimensionsreduktion?
Ja, ich biete PCA an, um Dimensionen zu reduzieren, Cluster zu visualisieren und die Leistung zu verbessern.
Kannst du auch Klassifikationsmodelle bauen?
Absolut. Ich kann KNN- und SVM-Modelle erstellen und bewerten, je nach deinen Anforderungen.
Bekomme ich Visualisierungen?
Ja – Cluster-Plots, PCA-Visualisierungen, Korrelations-Heatmaps, Pairplots und mehr (je nach Paket).
Können Sie mit unordentlichen oder unvollständigen Daten arbeiten?
Ja, ich kümmere mich um fehlende Werte, Ausreißer, Kodierung, Skalierung und vollständige Vorverarbeitung.
Wirst du mir die Ergebnisse erklären?
Natürlich. Ich liefere klare Erkenntnisse, Interpretationen und Empfehlungen basierend auf den Ergebnissen.
Geben Sie den Code an?
Ja, du erhältst sauberen, organisierten und gut kommentierten Python-Code (Jupyter Notebook oder .py-Datei).
Kannst du mir bei der Auswahl des richtigen Algorithmus helfen?
Ja – teile mir dein Ziel mit, und ich führe dich zur besten Clustering- oder Klassifikationsmethode.
Wie gewährleisten Sie Datenschutz und Sicherheit?
Deine Daten werden streng vertraulich behandelt. Ich teile, wiederverwende oder speichere deine Dateien niemals über das Projekt hinaus. Alles bleibt sicher und wird auf Wunsch sofort nach Lieferung gelöscht.