Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD

Automatische Übersetzung
Benötigst du ein maßgeschneidertes AI-System, kein Wrapper um eine API? Ich plane es, baue es von Grund auf neu und übergebe dir den Code.
Muhammad Omaid, Leiter AI bei Magnus Mage (gegründet 2019): über 8 Jahre in der Produktion, mehr als 10 Ingenieure, 4 AI-Systeme live.
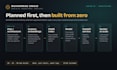
Die ersten 5 bis 10 Tage sind Planung: Architektur, Bibliotheksauswahl, ein schriftlicher Plan, den du vor dem Code genehmigst.
Was wir von Grund auf bauen:
RAG: maßgeschneiderte Embeddings, abgestimmtes Encoding und Decoding, FAISS oder pgvector, Retrieval in 3D, um Chunking und Recall zu optimieren.
Nach dem Training: SFT, DPO, QLoRA auf Llama, Qwen oder Mistral, mit Evaluationsberichten; private Inferenz auf deinen GPUs.
Multi-LLM: Routing zwischen offenen und gehosteten Modellen nach Kosten, Latenz und Datensensitivität.
FastAPI-Dienste mit Pydantic-Schemas, asynchronen Workern und OpenAPI-Verträgen.
Unternehmens-Docker-Container für hohen Traffic: Last getestet, überwacht, auf AWS, Kubernetes oder vor Ort.
Sicherheit: Authentifizierung, Ratenbegrenzung, Audit-Log.
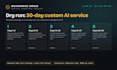
Pakete: MVP in 30 Tagen, Fortgeschritten in 45; Enterprise ist ein dediziertes Team für 10.000 $ pro Monat.
Du erhältst Quellcode, Architektur-Dokument, Lasttest- und Evaluationsberichte, CI/CD, Walkthrough-Video, Bug-Fix-Fenster.
Kontaktiere uns vor der Bestellung mit deinem Anwendungsfall, Daten und Traffic für ein individuelles Angebot.
Head of AI at Magnus Mage, LLM RAG and fine tuned models
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Was passiert in der Planungsphase?
Tage 1-5 (MVP) oder 1-10 (Fortgeschritten): Wir erfassen deinen Anwendungsfall, Daten und Traffic, wählen die Architektur und Bibliotheken (FastAPI, FAISS oder pgvector, Transformers, Docker, Kubernetes) und erstellen einen Plan mit Meilensteinen. Du genehmigst ihn, bevor Code geschrieben wird.
Was bedeutet RAG, das von Grund auf gebaut wird?
Keine Framework-Vorlagen. Wir trainieren oder optimieren maßgeschneiderte Embeddings, passen Encoding und Decoding für deine Dokumente an, indexieren in FAISS oder pgvector und clustern den Retrieval-Raum in 3D, um Chunk-Größe und Recall zu optimieren. Du erhältst Retrieval-Metriken, nicht nur einen Chatbot.
Was ist Post-Training und wann brauche ich es?
Post-Training passt ein offenes Modell (Llama, Qwen, Mistral) mit SFT, DPO oder QLoRA an deine Daten an. Du brauchst es, wenn Prompts und RAG nicht ausreichen: Domänensprache, strenge Ausgabeformate, Tool-Calling. Inklusive in Fortgeschritten und Enterprise, mit einem Evaluationsbericht vor und nachher.
Was ist Multi-LLM-Routing?
Eine API, mehrere Modelle. Anfragen werden nach Kosten, Latenz und Datensensitivität geroutet: sensible Daten bleiben auf deinem privaten Modell, allgemeine Aufgaben gehen an ein gehostetes Modell, mit Fallbacks und Kostenverfolgung pro Aufruf. Inklusive in Fortgeschritten und Enterprise.
Warum FastAPI und Pydantic?
FastAPI bietet asynchrone, hochdurchsatzfähige Dienste mit integrierten OpenAPI-Verträgen; Pydantic-Schemas validieren jede Anfrage und Antwort, sodass die LLM-Schicht niemals fehlerhafte Daten erhält oder zurückgibt. Beide sind von Grund auf für dein System geschrieben, keine Boilerplate-Generatoren.
Wie gehst du mit hohem Traffic um?
Unternehmens-Docker-Container mit asynchronen Workern und Queues, horizontale Skalierung auf Kubernetes oder AWS, Caching, Ratenbegrenzung und Lasttests bei deinem Zieltraffic vor Übergabe. Überwachung und Alarme sind in Fortgeschritten und Enterprise enthalten.
Kann das auf deiner eigenen Infrastruktur laufen?
Ja. Alles wird als Docker-Container ausgeliefert und läuft auf deiner Cloud (AWS, GCP, Azure), Kubernetes oder vor Ort GPUs. Für private Inferenz bedienen wir offene Modelle mit vLLM oder Ollama, sodass deine Daten niemals dein Netzwerk verlassen.
MVP, Fortgeschritten oder Enterprise: welches?
MVP (30 Tage): ein AI-Service mit RAG, FastAPI und Docker. Fortgeschritten (45 Tage): MVP plus ein nachtrainiertes Modell, Multi-LLM-Routing, 3D-Retrieval-Cluster und Überwachung. Enterprise: ein dediziertes Team für 10.000 $ pro Monat, mindestens zwei Monate, verlängerbar so lange du möchtest.
Was erhalte ich am Ende?
Quellcode in deinem Repository, Architektur-Dokument, Lasttest- und Evaluationsberichte, CI/CD-Pipeline, Docker-Images, ein Walkthrough-Video und ein Bug-Fix-Fenster. Du besitzt den Code, die Modellgewichte und die Daten.
Wie arbeiten wir zusammen?
Kontaktiere uns vor der Bestellung mit deinem Anwendungsfall, Daten und Traffic; wir antworten mit einem Plan und einem individuellen Angebot. Während des Baus: tägliche Updates auf Fiverr, Meilensteine, eine Demo am Ende jeder Phase. NDA auf Anfrage.


