Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Automatisierungs- und KI-Ingenieur
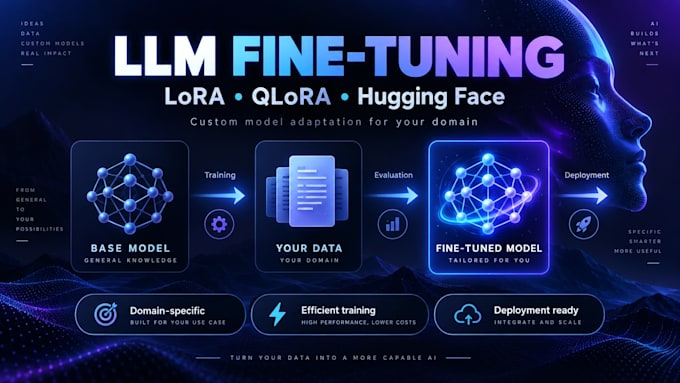
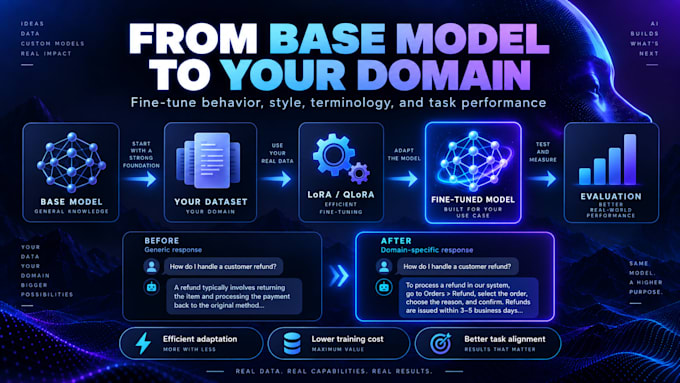
Suchst du nach einem LLM, das deine Domäne, Terminologie, Schreibstil, Aufgabe oder proprietären Datensatz besser versteht als das Basismodell?
Ich werde ein Open-Source Large Language Model mit modernen, parameter-effizienten Techniken wie LoRA und QLoRA mithilfe des Hugging Face-Ökosystems feinabstimmen.
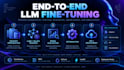
Anstatt nur ein Trainingsskript auszuführen, konzentriere ich mich auf den kompletten Feinabstimmungs-Workflow:
Datensatz -> Training -> Evaluation -> Inferenz -> Deployment
Ich kann dir bei folgenden Punkten helfen:
Ich kann mit geeigneten Open-Source-Modellen aus dem Hugging Face-Ökosystem arbeiten, darunter Llama-Familie, Qwen, Mistral, Gemma und ähnliche transformerbasierte Sprachmodelle.

Fortinet
Cybersecurity
I worked with Sken.ai, now acquired by Fortinet, on a short-term project, conducting machine learning experiments on proprietary data. Using AWS, I focused on finding patterns, clustering, and classification within textual data.
Apr. 2021-Apr. 2021
Automatische Übersetzung
Was ist LoRA?
LoRA ist eine parameter-effiziente Feinabstimmungstechnik, die ein großes Sprachmodell anpasst, indem sie eine relativ kleine Anzahl zusätzlicher Parameter trainiert, anstatt das gesamte Modell zu aktualisieren. Das reduziert den GPU-Speicherbedarf und die Trainingsanforderungen erheblich.
Was ist QLoRA?
QLoRA kombiniert Quantisierung mit LoRA, sodass große Modelle mit deutlich weniger GPU-Speicher feinabgestimmt werden können, während sie einen Großteil ihrer ursprünglichen Leistungsfähigkeit behalten. Das ist besonders nützlich, wenn die Rechenressourcen begrenzt sind.
Kannst du jedes Hugging Face Modell feinabstimmen?
Ich kann mit vielen transformerbasierten Modellen arbeiten, die eine praktische Feinabstimmung über das Hugging Face-Ökosystem unterstützen. Bitte sende mir das genaue Modell oder deine Anforderungen vor der Bestellung, da Hardware, Architektur, Lizenzierung und Dataset-Größe die Machbarkeit beeinflussen können.
Kannst du Llama-, Qwen-, Mistral- oder Gemma-Modelle feinabstimmen?
Ja, sofern das gewählte Modell, die Hardware, die Lizenzierung und die Projektanforderungen dies zulassen. Ich werde die Modellgröße und die Feinabstimmungsstrategie basierend auf deiner Aufgabe und den verfügbaren Rechenressourcen empfehlen.
Benötige ich einen Datensatz?
Ja. Feinabstimmung erfordert geeignete Trainingsdaten. Wenn dein Dataset leichte Umstrukturierungen oder Formatierungen benötigt, kann das je nach Paket eingeschlossen werden.
Wie viel Daten brauche ich?
Es hängt von der Aufgabe und der Qualität der Beispiele ab. Ein kleines, hochwertiges Dataset kann manchmal ein viel größeres, verrauschtes Dataset übertreffen. Ich werde das Dataset vor dem Training bewerten und empfehlen, ob es geeignet ist.
Kannst du garantieren, dass das feinabgestimmte Modell besser ist?
Kein verantwortungsbewusster KI-Entwickler sollte das vor dem Testen garantieren. Die Leistung hängt vom Basismodell, der Dataset-Qualität, der Dataset-Größe, der Trainingskonfiguration, der Bewertungsmethode und der Zielaufgabe ab. Deshalb ist die Bewertung in meinen Workflow integriert.
Soll ich RAG oder Feinabstimmung verwenden?
Sie lösen unterschiedliche Probleme. RAG ist in der Regel geeignet, wenn das Modell Zugriff auf sich änderndes oder privates Wissen benötigt. Feinabstimmung ist nützlich, wenn du das Verhalten des Modells, die Domänenanpassung, den Stil, die Terminologie, das Ausgabeformat oder die Leistung bei einer Aufgabe ändern möchtest. Einige Systeme profitieren von beidem.
Kannst du das feinabgestimmte Modell bereitstellen?
Ja. Das Premium-Paket kann eine Inference-API, Docker-Konfiguration, Deployment-Dokumentation und Integrationsanleitung enthalten. Kosten für Cloud-Infrastruktur und GPU-Hosting sind separat.
Wer bezahlt für GPU- oder Cloud-Training?
Alle erheblichen Drittanbieter-Kosten für GPU, API, Speicher oder Hosting werden vom Kunden getragen, sofern sie nicht ausdrücklich im individuellen Angebot enthalten sind. Ich bespreche die erwarteten Rechenanforderungen vor dem Training.
| (2) | ||
| (0) | ||
| (0) | ||
| (0) | ||
| (0) |
jo1hnj

Vereinigte Staaten
Suggested a creative solution to the problem. Delivery time was great. Clear documentation so the results are reproducible.
100 $-200 $
Preis
4 Tagen
Dauer
kr1s_ra

Österreich
Pleasure doing business. Very fast delivery.
50 $
Preis
3 Tagen
Dauer
| (2) | ||
| (0) | ||
| (0) | ||
| (0) | ||
| (0) |
jo1hnj
Vereinigte Staaten
Suggested a creative solution to the problem. Delivery time was great. Clear documentation so the results are reproducible.
100 $-200 $
Preis
4 Tagen
Dauer
kr1s_ra
Österreich
Pleasure doing business. Very fast delivery.
50 $
Preis
3 Tagen
Dauer