Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Daten in Lösungen mit Präzision verwandeln
Brauchst du einen Data Engineer für deine ETL-Pipelines? Droht dein Airflow-DAG zu scheitern? Ein Spark-Job geht dir der Speicher aus? Ich repariere kaputte Daten-Pipelines schnell und sorge danach dafür, dass sie nicht wieder kaputtgehen.
Genug von DAG-Fehlern um 2 Uhr morgens? Ich füge deiner Airflow + Spark-Stack einen AI-Agenten hinzu, der Ausfälle diagnostiziert, die sicheren automatisch behebt und dir einen klaren Root-Cause-Bericht für die restlichen Fälle liefert.
Was du bekommst:
Tech-Stack: Airflow, Spark, Kafka, NiFi, HDFS, MinIO, Agentic Frameworks.

Zielplattform:
PostgreSQL
•
mySQL
•
Apache Hive
•
Amazon S3
•
Andere
Automatische Übersetzung
Wie unterscheidet sich Agentic ETL von herkömmlichem ETL?
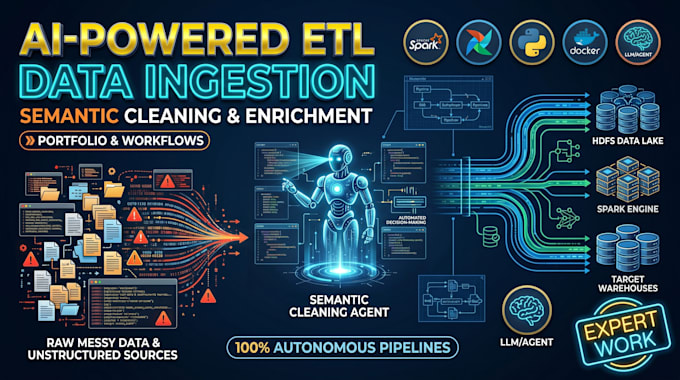
Herkömmliches ETL basiert auf starren, fest codierten Regeln, die bei Änderungen im Datenformat versagen. Meine agentischen ETL-Pipelines nutzen KI, um unstrukturierte oder chaotische Daten semantisch zu verstehen, zu parsen und zu bereinigen, bevor sie sicher in deinen HDFS-Datenlake eingespeist werden. Dadurch ist die Pipeline äußerst widerstandsfähig.
Sind meine Unternehmensdaten sicher, wenn ich diese AI-Agenten verwende?
Während wir kommerzielle APIs integrieren können, spezialisiere ich mich darauf, sichere, lokale LLMs wie Qwen, DeepSeek oder framework-basierte Agenten direkt in deiner containerisierten Umgebung bereitzustellen. So bleibt deine sensible Daten immer in deinem internen Netzwerk oder Cluster.
Muss ich meine aktuelle Infrastruktur migrieren?
Nein. Ich entwickle diese agentischen Workflows so, dass sie nahtlos mit deinem bestehenden Apache Airflow und Spark integriert werden. Ich verpacke alles mit Docker (oder Docker Swarm für hohe Verfügbarkeit), sodass es direkt an deine aktuelle Architektur angebunden werden kann.
Was passiert, wenn der Agent einen Fehler nicht beheben kann?
Er eskaliert. Du bekommst eine Slack- oder E-Mail-Benachrichtigung mit der Ursache, den relevanten Log-Zeilen und einem vorgeschlagenen Fix. Riskante Änderungen (Code, Schema, alles, was Produktionsdaten betrifft) benötigen immer deine Zustimmung. Der Agent behebt nur automatisch Fehler, bei denen wir uns auf die Sicherheit geeinigt haben.
Kannst du eine neue ETL-Pipeline von Grund auf neu erstellen, nicht nur eine reparieren?
Ja. Ich konzipiere und baue End-to-End-Datenpipelines: Ingestion aus APIs, Datenbanken oder Dateien, Transformation in PySpark oder Python, Orchestrierung in Apache Airflow und das Laden in PostgreSQL, S3, Hive oder dein Data Warehouse.