Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
KI-Ingenieur
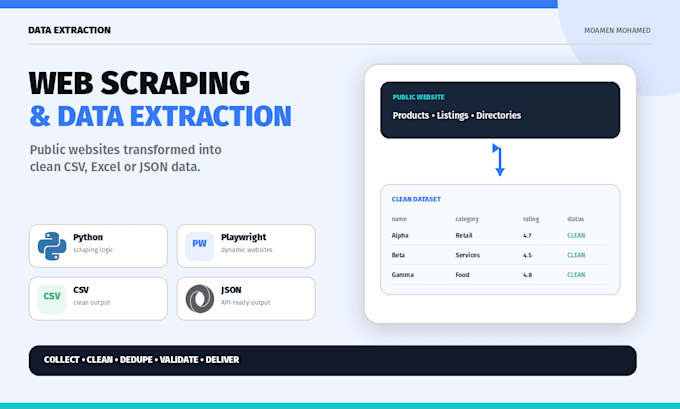
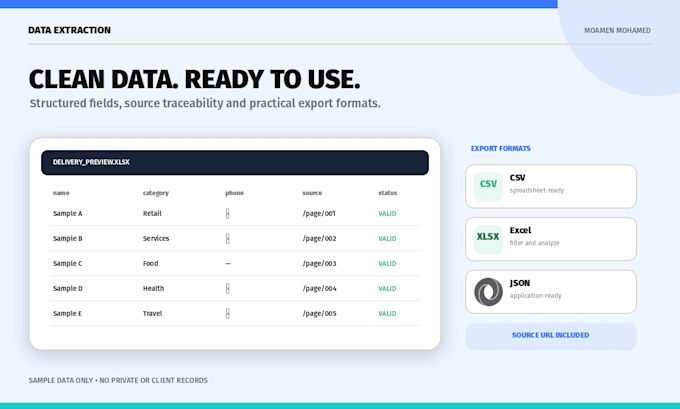
Brauchst du saubere Webdaten statt eines brüchigen Copy-and-Paste-Exports? Ich liefere validierte CSV-, Excel- oder JSON-Datensätze sowie wiederverwendbare Playwright-Scraper, basierend auf einem Projekt mit 9699 Einträgen, bei dem 35/35 Stichprobenprüfungen mit der Live-Quelle übereinstimmen.
Ich verwende Python, Requests und Playwright für Produktseiten, öffentliche Verzeichnisse, Listings, Artikel und andere autorisierte Quellen. Der Workflow kann JavaScript-Seiten, Paginierung und unendliches Scrollen verarbeiten, wenn diese im Paket enthalten sind.
Jede Lieferung umfasst die vereinbarten Felder, Grundreinigung, exakte Duplikatentfernung, Quellen-URLs, wenn verfügbar, und eine Live-Überprüfung gegen die Quelle.
Sende die Ziel-URL, Felder, erwartetes Volumen und Ausgabeformat vor der Bestellung. Ich umgehe keine CAPTCHAs, Paywalls, Zugriffskontrollen oder Kontoberechtigungen. Ich sammle keine privaten, geleakten oder geschützten persönlichen Daten.
Proxy-, API-, Konto- und Hostingkosten sind nicht inbegriffen.
Technologie:
Python
•
Dramatiker
•
Pandas
Informationstyp:
Notierungen
•
Produkte & Bewertungen
•
Websites
Technik:
Automatisiert
Automatische Übersetzung
Können Sie jede Website schaben?
Nein. Ich prüfe die Seite, Zugriffsregeln und technische Komplexität, bevor ich den Auftrag annehme.
Umgehst du CAPTCHAs, Paywalls oder Login-Beschränkungen?
Nein. Ich umgehe keine Zugriffskontrollen. Eine authentifizierte Quelle gilt nur, wenn du den Account besitzt, den Zugriff autorisierst und die Plattform die Nutzung erlaubt.
Ist Quellcode enthalten?
Das ist im Standard- und Premium-Paket enthalten. Basic liefert nur den Datensatz.
Was passiert, wenn die Website weniger Datensätze hat als das Paketlimit?
Ich liefere die Datensätze, die in der vereinbarten Quelle vorhanden sind. Ich erfinde keine fehlenden Datensätze.
Reinigen Sie die Daten?
Ja. Grundlegende Reinigung und genaue Duplikatentfernung sind enthalten. Komplexe Anreicherung, fuzzy Entity Matching oder Analyse erfordern ein individuelles Angebot.
Wird der Scraper ewig funktionieren?
Kein Scraper kann das garantieren, weil Websites ihr HTML, APIs und Schutzmaßnahmen ändern. Ich teste die gelieferte Version gegen die aktuelle Seite und kann Wartung separat anbieten.
Ist Scraping legal?
Die Rechtmäßigkeit hängt von der Quelle, Gerichtsbarkeit, Datentyp und Verwendungszweck ab. Du bist verantwortlich, deine Rechte zur Sammlung und Nutzung der Daten zu bestätigen, und ich kann riskante Quellen ablehnen.