Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
KI-Software-Ingenieur
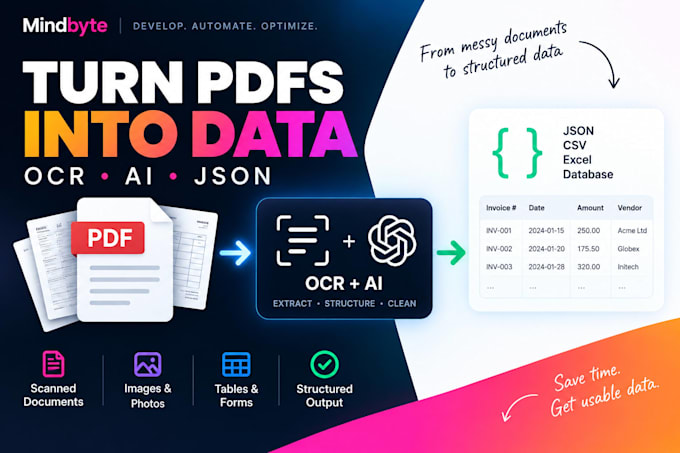
Ich erstelle OCR- und Dokumentenverarbeitungs-Pipelines, die PDFs, Scans und Bilder in strukturierte, nutzbare Daten umwandeln.
Ich kann Text, Tabellen, Daten, Referenzen, IDs und benutzerdefinierte Felder extrahieren, Dokumente klassifizieren, die Ergebnisse bereinigen und strukturierte JSON-, CSV- oder datenbankfertige Ausgaben liefern.
Je nach Projekt kann ich auch APIs, asynchrone Verarbeitung, semantische Suche oder RAG-Workflows entwickeln.
Mein Fokus liegt auf zuverlässiger, wiederverwendbarer Dokumentenverarbeitung, nicht auf einfacher einmaliger PDF-Konvertierung.
Bitte sende repräsentative Muster-Dokumente, bevor du komplexe Projekte bestellst.
Technologie:
Python
Automatische Übersetzung
Kannst du gescannte PDFs verarbeiten?
Ja. Ich kann gescannte PDFs und Bilder verarbeiten, inklusive Vorverarbeitung bei Bedarf.
Kannst du spezifische Felder extrahieren?
Ja. Daten, IDs, Referenzen, Titel, Dokumententypen und andere Felder können extrahiert werden.
Kannst du Dokumente klassifizieren?
Ja. Die Klassifikation kann je nach Anwendungsfall Regeln, maschinelles Lernen oder KI verwenden.
Kannst du Tabellen extrahieren?
Ja, abhängig vom Dokumentenlayout und der Scanqualität.
Kannst du eine API um die Pipeline herum bauen?
Ja. REST-API und Hintergrundverarbeitung können hinzugefügt werden.
Kannst du große Volumina verarbeiten?
Ja, aber hochvolumige Workflows erfordern in der Regel einen individuellen Umfang.
