Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD


Automatische Übersetzung
Hör auf, monatliche OpenAI-Gebühren zu zahlen, schütze deine Daten mit 100% privater lokaler AI!
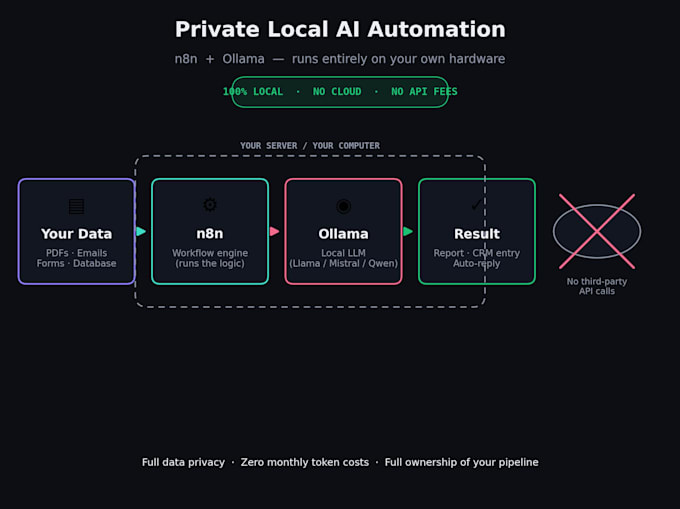
Willst du AI-Automatisierung ohne Datenschutzrisiken oder teure Token-Gebühren? Ich baue selbstgehostete AI-Systeme mit n8n + Ollama, die komplett auf deiner Hardware oder deinem privaten Server laufen.
Warum lokale AI?
100% Datenschutz – nichts verlässt deine Infrastruktur
Keine API-Kosten, unbegrenzte Nutzung von Llama 3, Mistral, Qwen, DeepSeek
Volle Kontrolle über deinen Server, Workflows & LLM-Parameter
Was ich baue:
So arbeiten wir:
1️ Entdeckung – Ziele & Sicherheitsanforderungen definieren
2️ Einrichtung – n8n + Ollama auf deiner Hardware/VPS konfigurieren
3️ Entwicklung – Logik deiner AI entwerfen, testen, optimieren
4️ Übergabe – vollständige Dokumentation + Video-Anleitung
AI Automation and Private LLM Specialist,n8n and Ollama Expert
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Brauche ich leistungsstarke Hardware, um das lokal laufen zu lassen?
Das hängt von der Größe des AI-Modells ab. Kleinere Modelle laufen gut auf einem modernen CPU oder einer Mittelklasse-GPU. Für größere Modelle oder schnellere Reaktionszeiten ist eine GPU (auch eine Consumer-GPU wie eine RTX 3060+) empfehlenswert. Ich prüfe deine Specs während der Discovery-Phase und empfehle das passende Modell – ganz ohne Rätselraten.
Ich habe keinen Server – kannst du mir trotzdem helfen?
Ja. Wenn du keine lokale Hardware oder VPS hast, kann ich dir beim Einrichten helfen (z.B. Hetzner, DigitalOcean, Contabo) oder einen Anbieter empfehlen, der zu deinem Budget und Bedarf passt.
Bleiben meine Daten wirklich privat?
Ja – mit diesem Setup verlässt deine Daten niemals deine eigene Infrastruktur. Im Gegensatz zu Cloud-APIs (OpenAI usw.) gibt es keine externen Anfragen, die deine Daten an Dritte senden. Alles läuft lokal.
Ist ein lokales Open-Source-Modell (Llama, Mistral, Qwen) so gut wie ChatGPT/GPT-4?
Für gut abgegrenzte Business-Aufgaben (Dokument-Extraktion, Lead-Scoring, interne Q&A) schneiden lokale Modelle sehr gut ab und sind oft 'gut genug' oder besser, sobald sie auf deinen Anwendungsfall abgestimmt sind. Sie sollen keine allgemeinen Chatbots für jede Aufgabe ersetzen.
Was passiert nach der Lieferung – kann ich Änderungen selbst vornehmen?
Ja. Du erhältst vollständige Dokumentation und eine Video-Anleitung, die erklärt, wie der Workflow funktioniert, damit du (oder dein Team) grundlegende Anpassungen selbst vornehmen kannst. Ich stehe auch für laufenden Support und Wartung zur Verfügung, falls du es nicht selbst verwalten möchtest.
Wie lange dauert die Lieferung?
Die Lieferzeit hängt vom Paket und der Komplexität des Projekts ab – siehe die oben genannten Preiskategorien. Komplexe Integrationen (Datenbanken, Feinabstimmung) dauern länger und sind in den Standard-/Premium-Paketen enthalten.
Was, wenn das Modell meine Dokumente/Daten nicht gut genug versteht?
Genau dafür ist die Discovery-Phase da – wir testen früh mit einem Beispiel deiner echten Daten, damit wir Genauigkeitsprobleme erkennen, bevor wir vollständig liefern, nicht danach.
Bietest du laufende Wartung nach Projektabschluss an?
Ja, das kann separat als monatliches Retainer-Paket arrangiert werden, falls du möchtest, dass ich deine Workflows nach Übergabe weiterhin pflege, aktualisiere oder erweitere.
