Kategorien durchsuchen
Deutsch
$
USD
Verbinden Sie sich mit Ihrer KI
AI-Agent, Automatisierungs- und ML-Entwickler
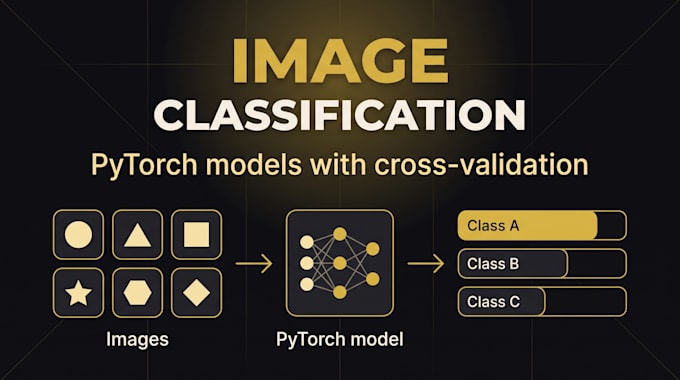
Willst du deine Bilder automatisch sortieren lassen? Ich trainiere PyTorch-Bildklassifikationsmodelle und bewerte sie ehrlich, damit du weißt, wie sie bei Daten abschneiden, die sie noch nicht gesehen haben.
Jedes Paket umfasst Datenvorverarbeitung, ein fein abgestimmtes Modell, Tests auf zurückgehaltenen Daten, Quellcode und Dokumentation.
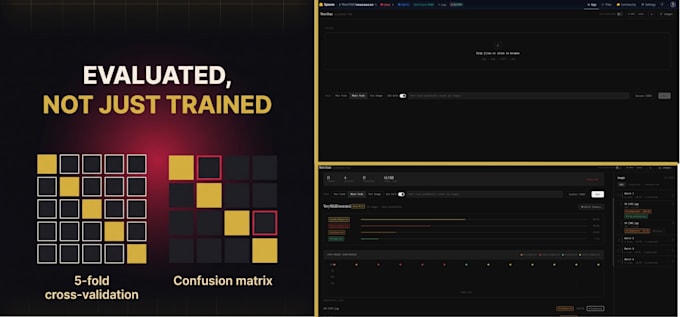
Mein eigenes Projekt, NeuroScan, klassifiziert 6400 MRT-Scans in 4 Klassen mit 98,95% durchschnittlicher Makro-Rückrufrate bei 5-facher Kreuzvalidierung (nur Forschung, kein klinisches Werkzeug).
Modelle: Basic 1, Standard bis 2, Premium bis 3. PyTorch standardmäßig; TensorFlow, Keras oder Objekterkennung auf Anfrage.
Du stellst einen beschrifteten Datensatz bereit (bis zu etwa 2000 / 10000 / 20000 Bilder pro Paket). Ich trainiere auf Colab; für eine größere GPU stellst du Zugang bereit oder deckst die Kosten. Hosting-Kosten gehen zu deinen Lasten. Ich kann keine bestimmte Genauigkeit garantieren, da die Ergebnisse von deinen Daten abhängen.
Schreib mir eine Nachricht mit dem, was du klassifizieren möchtest, und einem Datenmuster, dann empfehle ich dir ein Paket.


Automatische Übersetzung
Welche Art von Bildern und Aufgaben kannst du bearbeiten?
Jede Bildersammlung mit Labels, die du in Klassen sortieren kannst: Produkte, Dokumente, Defekte, Pflanzen, Scans und mehr. Ein Label pro Bild funktioniert am besten. Multi-Label, Segmentierung und Objekterkennung sind andere Aufgaben, also schreib mir zuerst.
Was muss ich bereitstellen?
Ein beschrifteter Datensatz, idealerweise ein Ordner pro Klasse oder eine CSV mit Bildpfaden und Labels, plus eine kurze Beschreibung, wie das Modell verwendet wird. Eine grobe Richtlinie sind mindestens 100 Bilder pro Klasse. Dataset-Validierung ist im Premium enthalten oder als Extra verfügbar.
Kannst du eine bestimmte Genauigkeit garantieren?
Nein. Die Ergebnisse hängen von der Qualität deiner Daten, der Label-Qualität, dem Klassen-Gleichgewicht und der Aufgabenstellung ab. Ich liefere ehrliche Zahlen bei ungesehenen Daten und sage dir frühzeitig, wenn die Daten für das Ziel zu schwach sind.
Was ist Kreuzvalidierung und warum ist sie wichtig?
Anstatt einmal auf einer einzelnen Aufteilung zu testen, werden die Daten in 5 Teile aufgeteilt und das Modell wird 5-mal trainiert und getestet. Du erhältst einen Durchschnitt und eine Streuung, die zeigt, ob ein gutes Ergebnis Glück war. Ich nehme es im Standard-Paket auf.
Was ist, wenn einige Klassen deutlich weniger Bilder haben als andere?
Das ist üblich. Im Standard behandle ich das mit Techniken wie Fokussierter Verlustfunktion und Klassengewichtung, und ich bewerte das Modell anhand von Metriken wie Makro-Rückruf, nicht nur der Gesamtgenauigkeit, damit seltene Klassen nicht ignoriert werden.
Welche Frameworks und Modelle verwendest du?
PyTorch standardmäßig, mit bewährten vortrainierten Backbones (z.B. ResNet, EfficientNet oder Vision Transformer), fein abgestimmt auf deine Daten. TensorFlow oder Keras sind auf Anfrage verfügbar; sag mir vor der Bestellung Bescheid, damit ich die Kompatibilität bestätigen kann.
Was bekomme ich und was bedeutet Monitoring?
Modelgewichte, Quellcode, eine dokumentierte Pipeline und deine Ergebnisse. Das Standard-Paket enthält MLflow-Leistungs-Tracking und einen FastAPI-Endpunkt in Docker; Premium ergänzt Vorhersage- und Latenz-Logging sowie einen Walkthrough-Call. Monitoring bedeutet Verfolgung und Logging, keine Live-Dashboards oder Alarme.
Hostest du das Modell oder die API?
Ich biete kein Hosting an. Premium beinhaltet das Deployment der API in deine Cloud, auf deinen Server oder in einen Hugging Face Space; du gibst mir Zugriff und zahlst die Hosting-Kosten. Standard liefert dir ein Docker-Image, das du selbst bereitstellen kannst.
Kann ich es für medizinische oder sicherheitskritische Entscheidungen verwenden?
Nein. Meine Modelle sind für allgemeine Bildsortierung und Forschungszwecke entwickelt. Mein NeuroScan-Projekt ist eine Forschungs-Demo, kein klinisches Werkzeug. Alles Medizinische oder sicherheitskritische erfordert eine ordnungsgemäße Validierung und behördliche Überprüfung außerhalb dieses Gigs.
Was passiert, wenn ich mit den Ergebnissen nicht zufrieden bin?
Fehler in meinen gelieferten Ergebnissen werden durch deine Revisionen behoben (1 im Basic, 2 im Standard, 3 im Premium). Die Ergebnisse hängen von deinen Daten ab, daher ist eine Verbesserung durch mehr Daten, zusätzliche Modelle oder längeres Tuning eine neue Bestellung oder ein Extra.